北京数据知识产权登记再添垂直场景成果 中哈平行语料数据集落地 赋能跨境智能交互
随着我国数据要素市场化配置改革持续深化,数据知识产权登记作为明确数据权属、保障数据权益、规范数据流通的核心基础制度,正在为细分领域数据资产的合规运营与价值释放提供制度支撑。与此同时,伴随“一带一路”倡议下中哈两国经贸、文化、科技、民生等领域的交流合作不断深入,跨语言智能交互工具的市场需求持续攀升,高质量、合规化的中哈平行语料资源,成为制约相关AI技术落地的核心瓶颈之一。
作为国内头部AI训练数据服务商,数据堂长期专注于多语种语料、多模态训练数据的采集、标注与合规运营,此次完成登记的人工智能中文-哈萨克文平行语料文本数据集,正是面向中哈跨语言交互场景定向研发的专项数据资源。该数据集针对中文与哈萨克文(西里尔文)平行语料的采集与标注需求打造,所有语料均由成对的中文文本与经过专业校对的哈萨克文译文组成,内容覆盖科技、医疗、旅游、新闻及日常口语等多个高频应用领域,配套唯一编号标识与标准化双语对齐标注,可直接为相关人工智能模型提供高质量的训练与评测语料。
从应用价值来看,该数据集首先可用于中哈双向神经机器翻译模型的训练、评测及优化,显著提升翻译系统对哈萨克文这一哈萨克斯坦主要官方语言的翻译质量与鲁棒性,降低复杂语境下的翻译误差。除此之外,该数据集还可广泛应用于跨语言信息检索、双语词典构建与语言学研究等领域,能够支撑中哈跨境电商智能客服、跨境旅游导览翻译、跨境政务服务多语种交互、学术文献跨语言检索等多类产品的算法验证与效果调优,为两国多领域交流的数字化落地提供基础数据支撑。
此次完成北京市数据知识产权登记,标志着该数据集的权属合法性、内容合规性得到官方认定,不仅为数据堂后续开展该数据集的授权运营、流通交易提供了权益保障,也为国内多语种语料类数据资产的知识产权登记、合规流通提供了可参考的实践样本,对于丰富我国垂直场景数据要素供给、支撑“数字丝绸之路”建设具有积极意义。
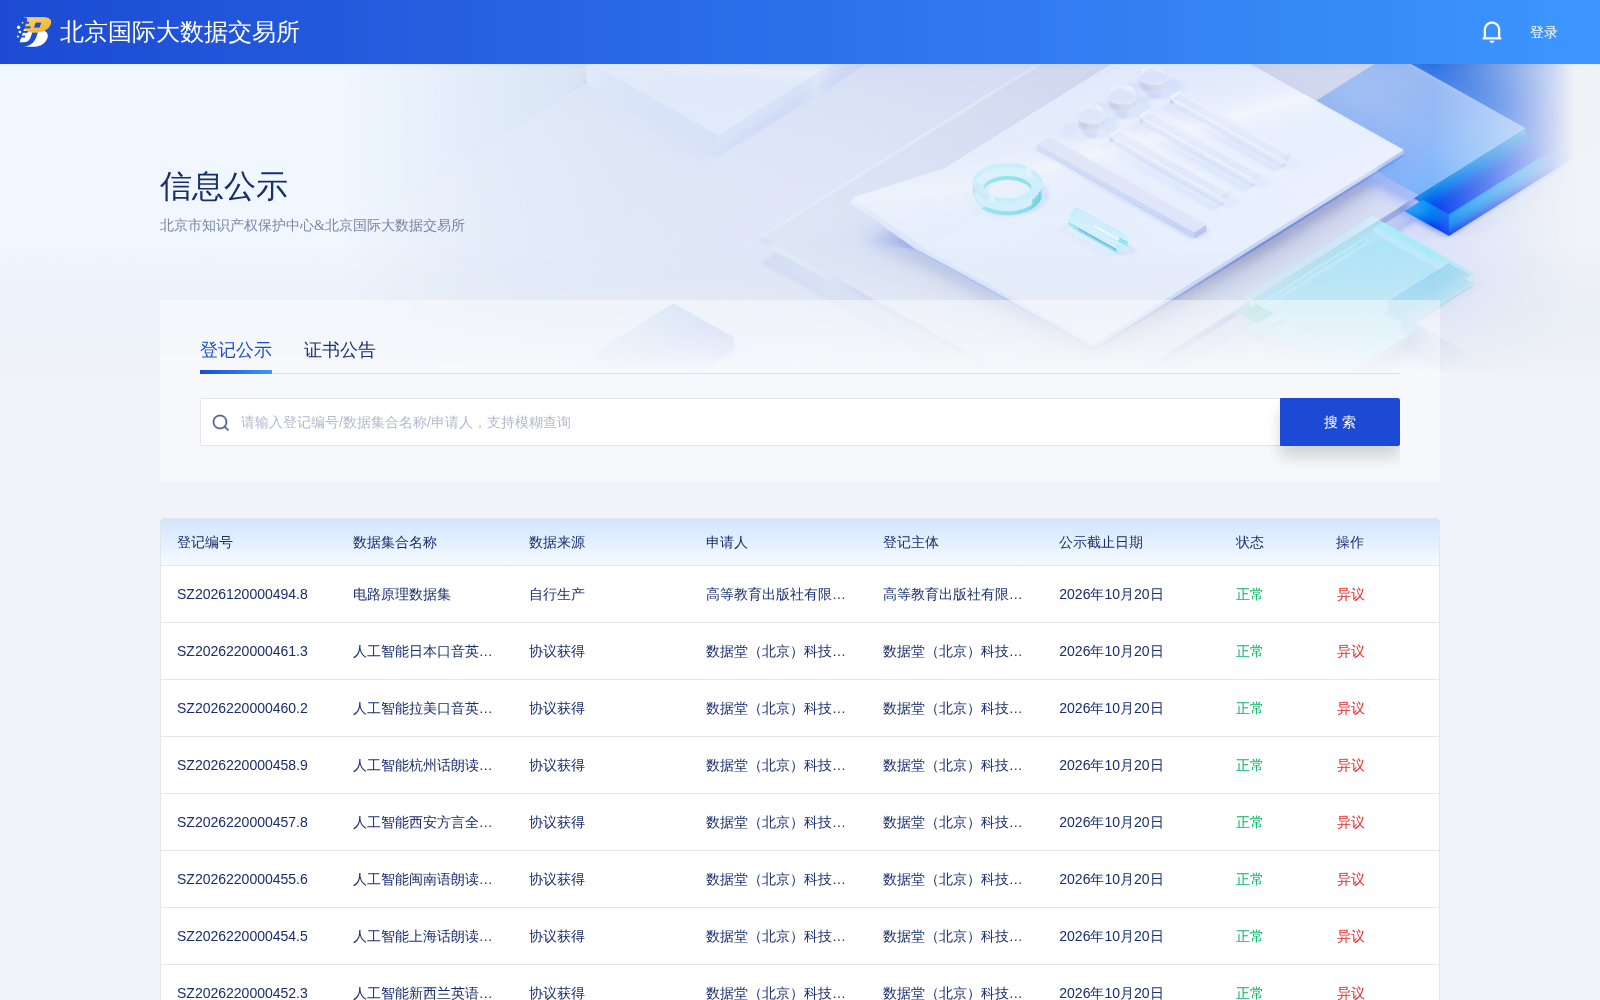
登记内容: