

北京数据知识产权登记再添跨境NLP资源 数据堂中泰平行语料数据集完成合规确权 可支撑多领域数字化应用
当前我国数据要素市场化建设已进入“确权赋能、合规流通”的深化阶段,北京市作为全国首批数据知识产权工作试点城市,其搭建的数据知识产权登记体系具备权益证明、流通溯源、司法采信等多重效力,是国内规范数据资产权属、推动数据资源合规交易的核心基础设施,此前已完成多个垂直领域高价值数据集的登记备案,为国内数据要素市场的规范化发展提供了试点样本。
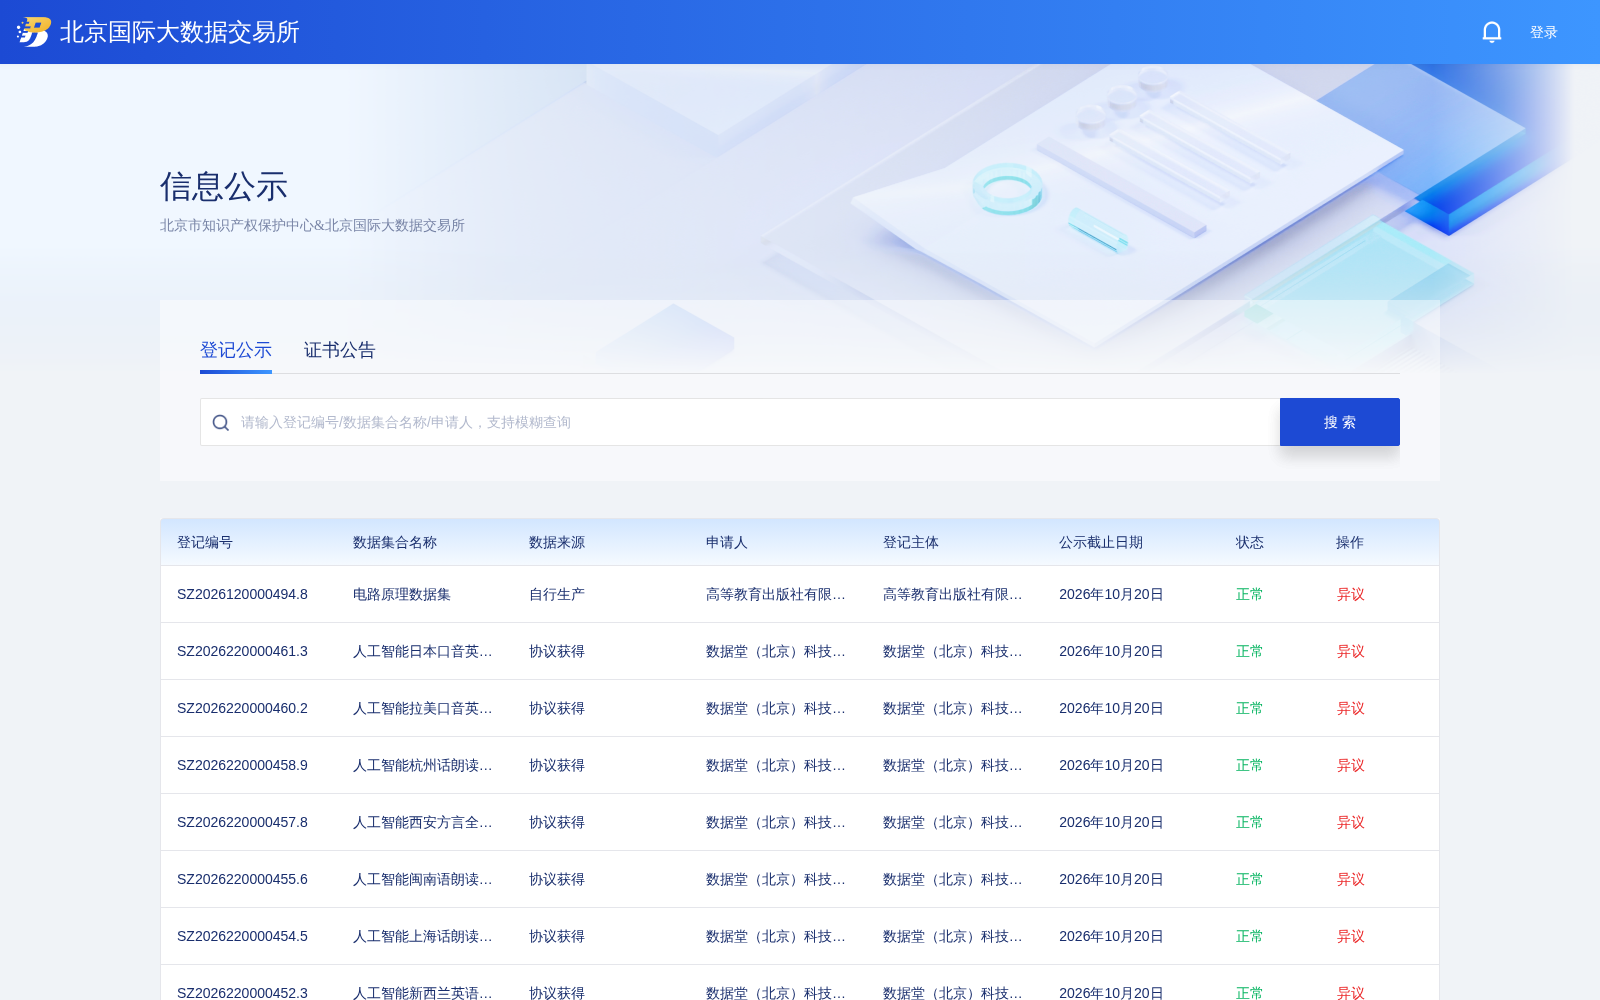
2026年9月30日,数据堂(北京)科技股份有限公司旗下人工智能中文-泰文平行语料数据集正式通过北京市数据知识产权登记审核,成为目前国内少有的完成合规确权的东南亚小语种自然语言处理(NLP)基础资源。本次登记的数据集所有语料均经过专业标注校验与合规审核,收录海量中文句子及其对应的精准泰文译文,不存在版权争议与合规风险,可直接面向各类市场主体开放授权使用。
作为中泰双语AI应用的核心基础资源,该数据集可面向多个垂直领域提供底层数据支撑,典型应用场景包括: 1)机器翻译系统构建:为中文-泰文神经机器翻译模型的训练与评测提供高质量平行句对,支撑编码器-解码器与大规模多语预训练模型在中泰方向的对齐学习,提升翻译系统对双语句法、专业术语的覆盖能力,可广泛应用于跨境电商客服、文旅即时翻译、外贸文档处理等场景,解决过往中泰互译准确率偏低、专业场景覆盖不足的痛点; 2)跨语言检索与信息抽取:为面向泰文互联网内容的跨语言检索、关键词对齐与实体抽取提供中泰对照语料,支撑跨境电商选品、海外舆情监测、本地化内容自动分类与聚合等需求,大幅降低中资企业布局泰国市场的信息获取成本,提升跨境运营效率; 3)双语教学与辅助阅读:为泰语学习者与中文母语者的双向语言学习应用提供标准对照例句,支撑智能教育产品的例句推送、译文评测与错误诊断功能,改善双语学习效率,可适配留学备考、文旅日常交流等多种学习需求; 4)泰文自然语言处理基础能力建设:为泰文分词、词性标注与句法分析等上游任务提供中文侧语义锚点,支撑低资源泰文方向的自然语言处理模型训练与迁移学习,填补国内泰文NLP基础训练资源的供给缺口。
登记内容:
业内人士指出,本次中泰平行语料数据集的成功登记,不仅为国内面向东南亚的跨境数字化服务提供了合规的基础数据支撑,也为小语种语料、垂直领域NLP数据集的确权登记提供了可参考的实操样本,进一步丰富了北京数据知识产权登记的资源品类,对推动我国面向“一带一路”沿线国家的数字服务贸易发展、完善跨境数据要素供给体系具有重要的示范意义。



