北京:人工智能阿拉伯语自然说话语音数据集完成数据知识产权登记 赋能跨境智能语音产品落地
当前全球数字经济跨境融合进程加速,中东、北非(MENA)地区作为全球数字经济增速最快的区域之一,阿拉伯语作为22个国家官方语言、覆盖超4亿人口的核心语种,对应的智能语音交互技术需求持续爆发。而高质量、合规化的标注语音数据集,是阿语语音识别大模型训练、算法优化的核心生产资料,也是国内科技企业出海布局MENA市场的核心刚需。与此同时,我国数据要素市场化配置改革正在加速推进,数据知识产权登记作为明晰数据权益归属、打通数据合规流通链路的核心制度安排,为数据资产的价值变现、权益保护提供了官方依据。
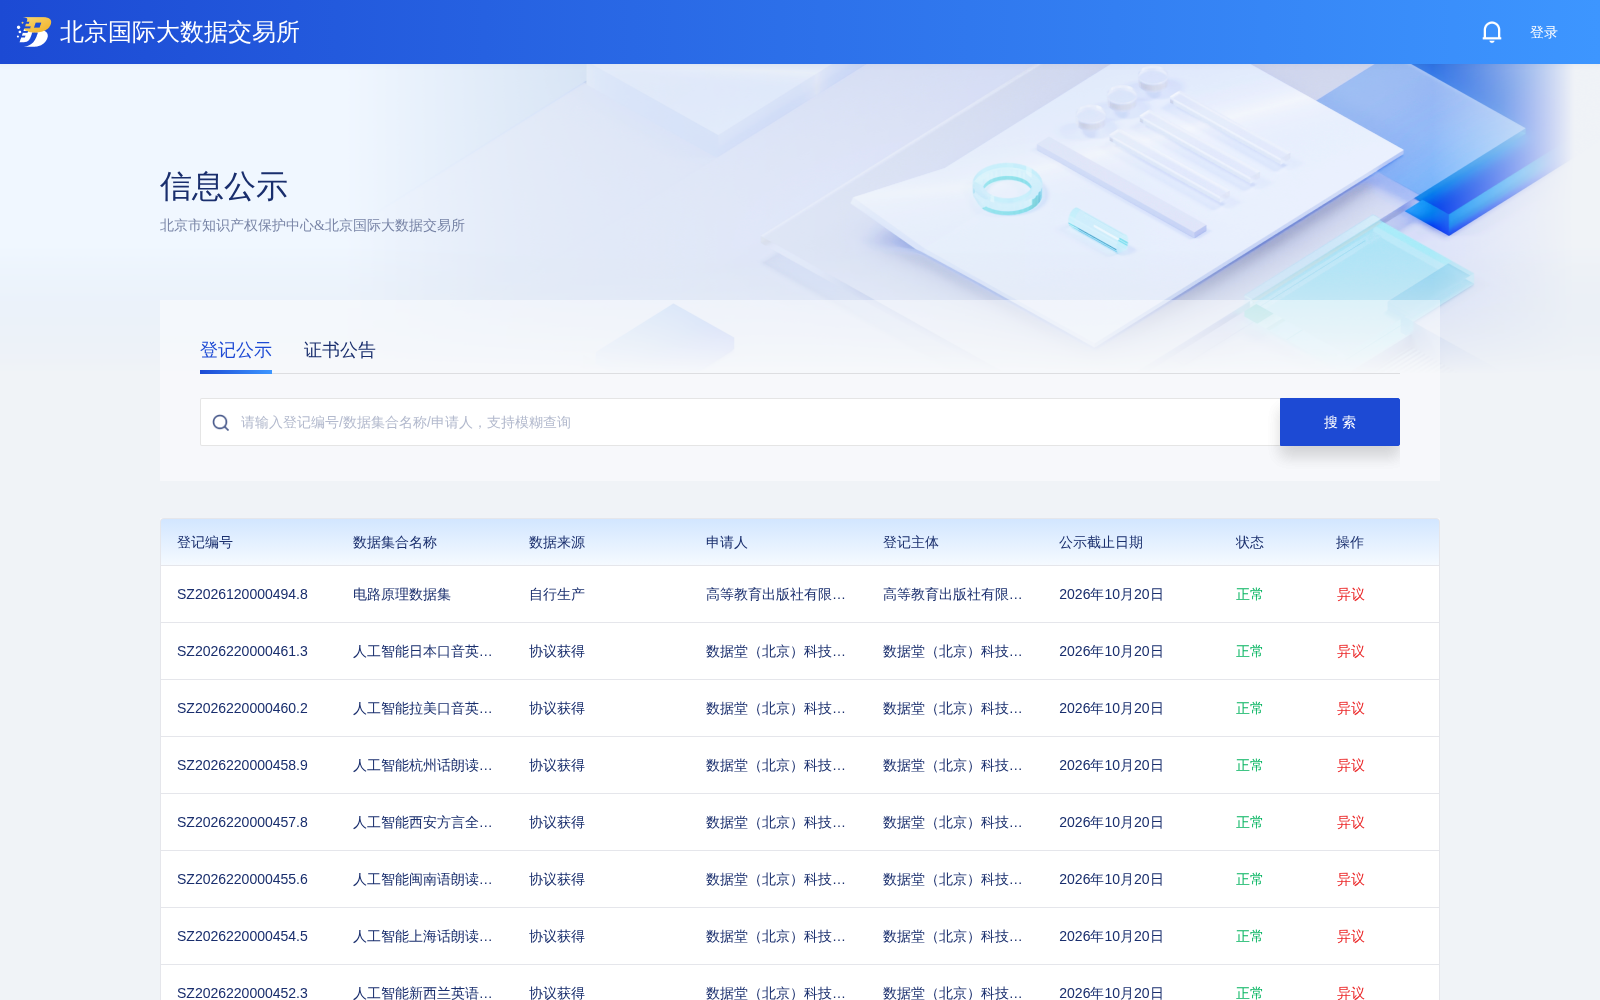
2026年9月30日,国内专业AI训练数据服务商数据堂(北京)科技股份有限公司旗下的人工智能阿拉伯语自然说话语音数据集,正式完成北京市数据知识产权登记。本次登记的数据集是专门面向阿语自然口语场景打造的高品质训练数据资产,以真实自然说话模式采集阿拉伯语语音样本,最大程度还原了日常交流中的口语化表达特征,覆盖不同音素、韵律、语流层面的真实声学规律,可有效支撑语音识别模型对阿语真实对话场景的深度学习与建模,显著提升阿语语音转写的准确率与复杂环境下的鲁棒性,为阿语语音识别声学模型、语言模型的训练优化及算法研究提供高质量数据支撑。
从应用场景来看,该数据集除了可用于阿语语音识别算法的研究与评测、支持声学模型与语言模型的联合优化之外,还可广泛服务于多类落地场景:包括面向C端的阿语智能语音助手、语音输入法、实时翻译硬件,面向B端的智能客服、车载语音交互系统、跨境电商语音导购,以及面向公共服务领域的智慧教育语音交互、政务便民语音应答等产品研发,全面覆盖面向中东及北非语言市场的智能语音产品开发需求,助力相关企业降低研发成本、缩短产品落地周期,推动阿语智能语音识别技术的持续迭代与普及应用。
本次完成北京市数据知识产权登记,也标志着该数据集的权益归属得到官方认可,后续在授权使用、交易流转过程中将受到知识产权相关法规的保护,既保障了数据生产方的研发投入收益,也为下游使用方规避了数据来源不合规的法律风险,为数据要素跨主体、跨区域合规流通提供了典型样本。
登记内容: