浙江完成唇部标注质量评估数据知识产权登记 为AI数字人训练筑牢质量底座
随着生成式AI、数字人产业进入规模化落地阶段,训练数据的质量优劣直接决定了AI模型的输出效果与落地体验,而训练数据相关资产的知识产权确权,也成为数据要素市场化流通中亟待突破的核心环节。作为国内率先落地的省级官方数据知识产权登记载体,浙江省数据知识产权登记平台承担着数据资产权属确认、流通凭证背书、合规交易支撑的核心职能,为各类数据资产的规范化市场化应用打通了前置路径。
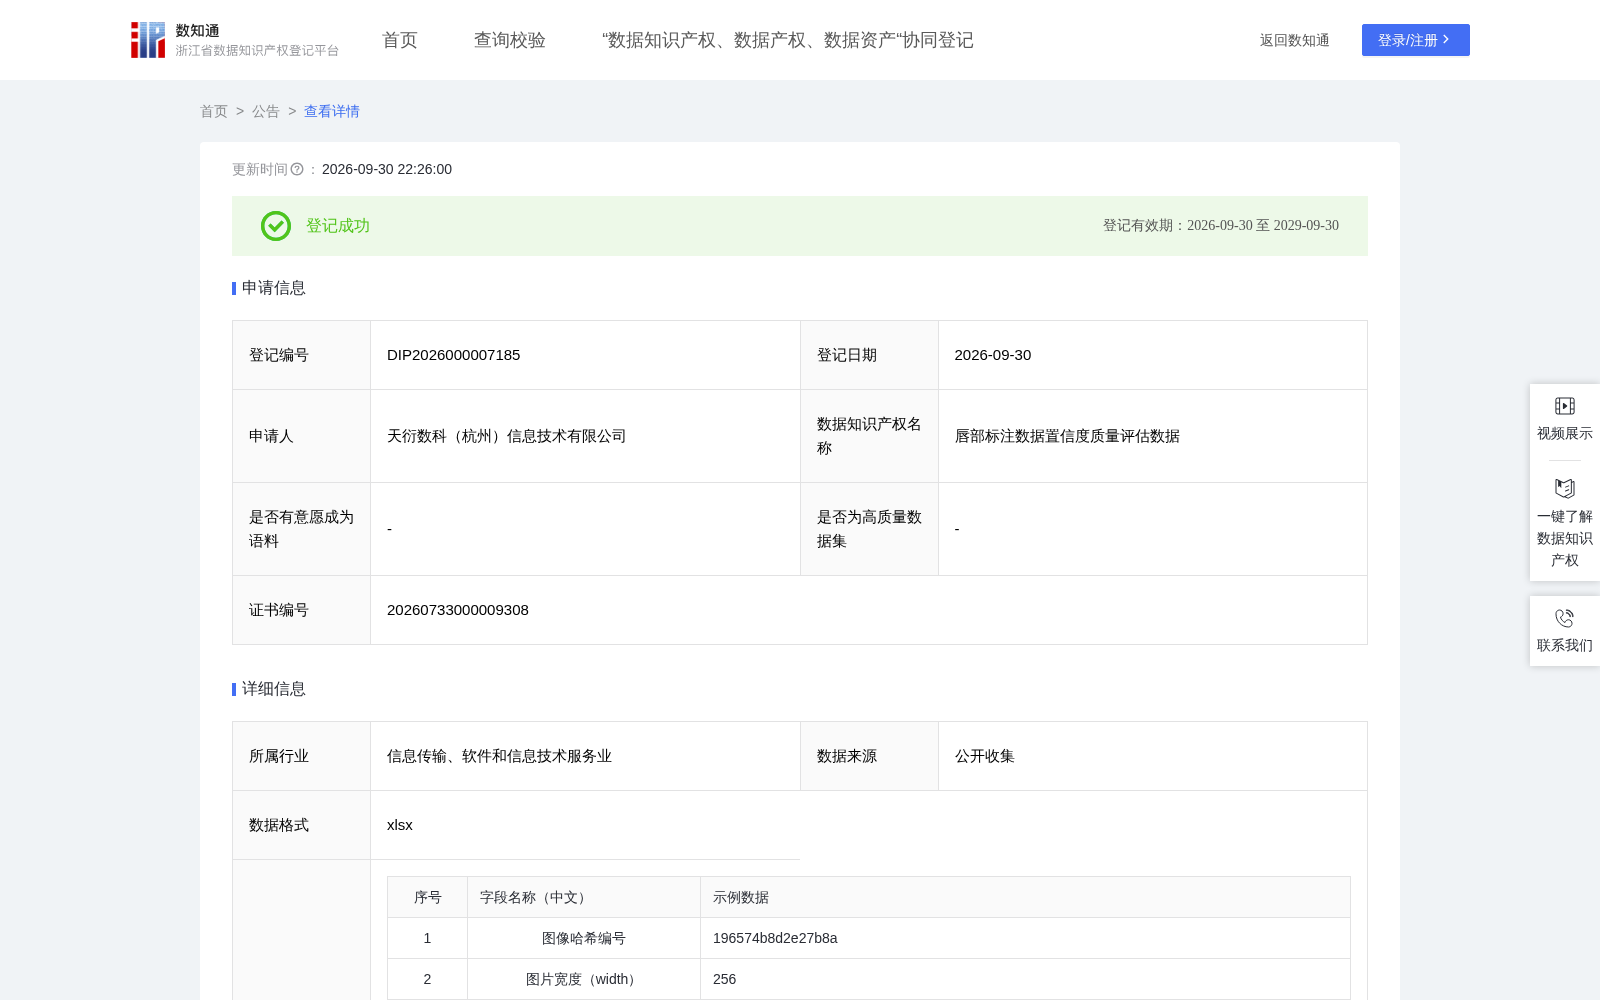
2026年9月30日,天衍数科(杭州)信息技术有限公司旗下唇部标注数据置信度质量评估数据正式在该平台完成知识产权登记,是国内为数不多完成官方确权的AI训练数据质量评估类专项数据集。
数据质量是AI模型训练效果的核心基石,对唇部标注数据的置信度进行系统性质量评估,不仅能够识别低质量样本、优化训练集构成,还能为标注流程的改进提供量化依据。据介绍,本次登记的唇部标注数据置信度质量评估数据集,正是聚焦唇部标注环节的质量量化评估需求设计,每条样本覆盖检测置信度(confidence)、检测质量指数(detection_quality_index)、关键点置信度(keypoints_conf)、归一化边界框宽度(bbox_w_norm)、归一化边界框高度(bbox_h_norm)五大核心质量评估维度,并附带结构化语料字段(Text),全量数据覆盖置信度与质量指数的完整分布范围,可直接支撑质量评估模型的训练与验证工作。
为保障评估维度的科学性与通用性,该数据集搭建了多维度质量评估分类分析框架:在质量特征提取阶段,评估网络会对每张标准尺寸图像提取上述核心参数,结合归一化边界框参数构建质量特征向量,并将各参数统一写入Text字段;在模型训练阶段,采用预训练模型,设置训练轮次为300、学习率为0.01、子节点数为31,通过指定框架加载完成质量认知训练,最终生成标注置信度、样本质量和样本难度三类核心评估指标。
从落地场景来看,该数据集可直接服务于标注数据质量自动评估模型构建、低质量样本过滤策略研究及标注流程优化系统开发,除了为AI数字人领域提供质量评估维度的专项训练语料外,还可广泛应用于唇语识别模型训练、虚拟主播口型匹配优化、智能客服数字人交互体验升级等多个细分场景,帮助相关企业降低标注环节的人工核验成本,提升AI模型的训练效率与输出准确性。
本次登记完成后,该数据集的知识产权归属获得官方背书,后续在交易、授权、流通等环节将拥有合规凭证,既降低了数据资产的流通风险,也为AI训练配套类数据资产的确权登记提供了可参考的实践样本,对完善细分领域数据要素品类、推动AI产业数据供应链的合规化建设具有积极意义。
登记内容: