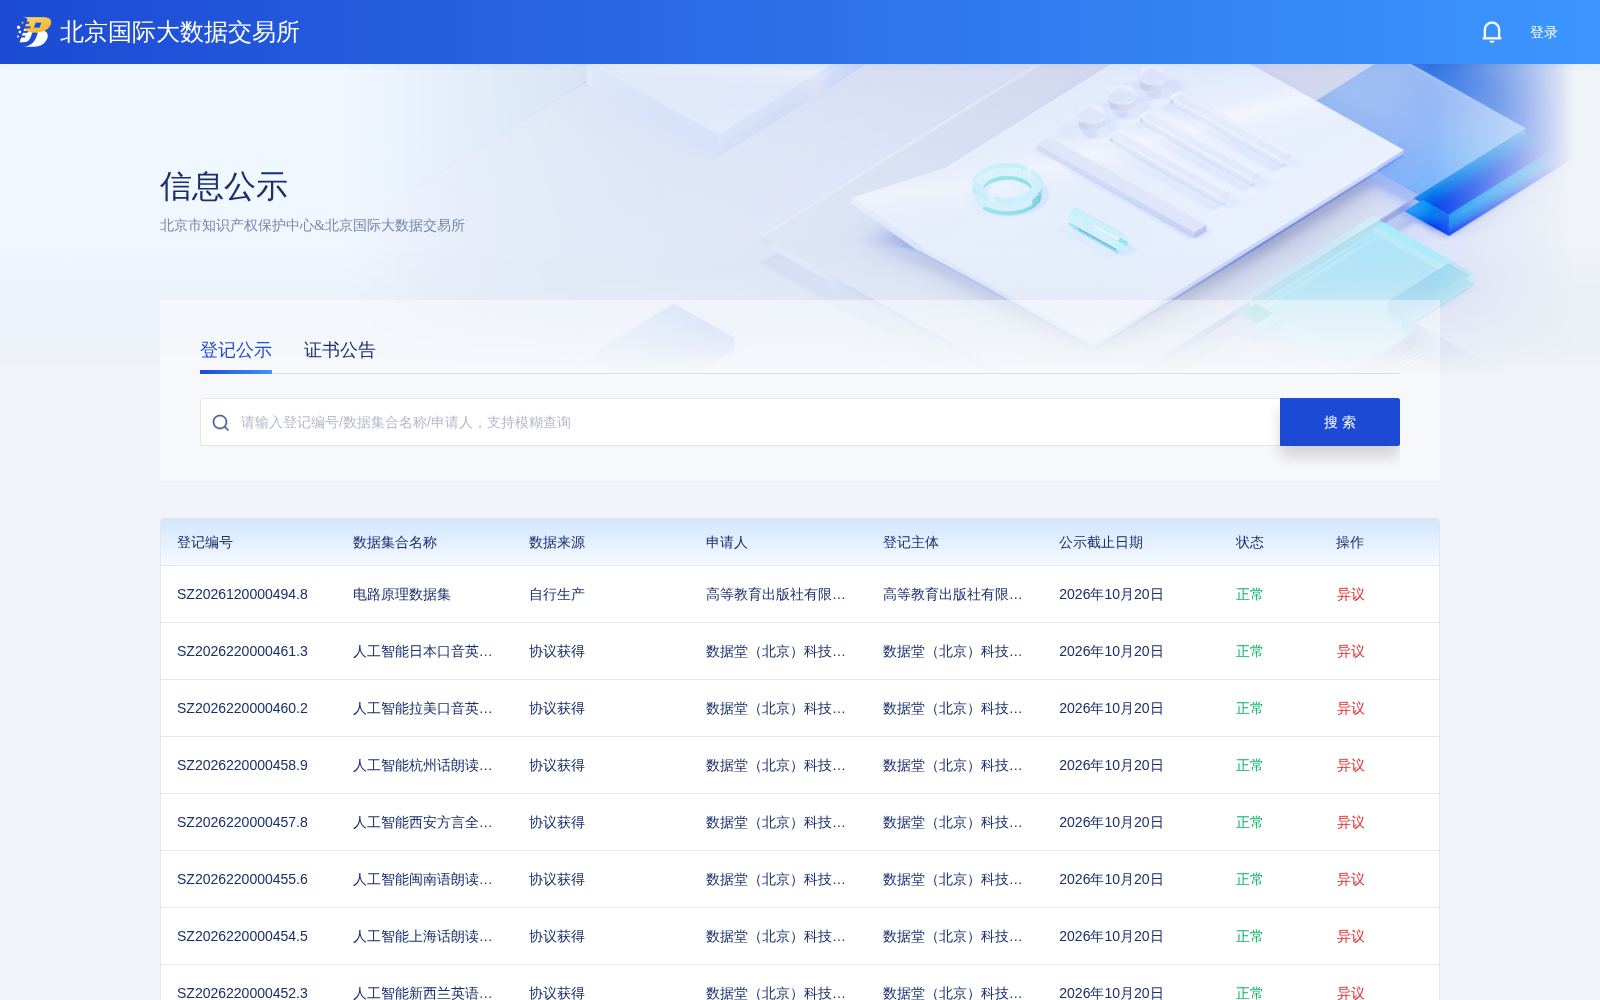
数据堂英土平行语料数据集在京完成知识产权登记 为跨语言AI研发提供合规数据支撑
随着全球跨境数字贸易、文化交流频次持续提升,多语种智能交互、跨语言信息处理等AI应用场景呈现爆发式增长,高质量、合规化的标注语料数据集已成为AI大模型、机器翻译等技术迭代的核心生产要素。作为国内数据要素市场化配置改革的先行试点,北京市搭建的数据知识产权登记体系,通过对数据资源的权属核验、官方存证与公开公示,为数据要素的确权、流通、增值应用提供了标准化的合规路径,近期多个垂直领域的优质数据资源先后通过该通道完成登记。
2026年9月30日,数据堂(北京)科技股份有限公司旗下人工智能英文-土耳其文平行语料文本数据集正式完成北京市数据知识产权登记,成为跨语言AI训练数据领域又一获得官方权属背书的标准化数据产品。
据了解,本次登记的英土平行语料文本数据集面向英文与土耳其文平行语料的采集与标注场景打造,核心由成对的英文文本与对应的专业土耳其文译文组成,配套统一编号标识与高精度双语对齐标注,可直接为相关人工智能模型提供高质量的英土平行训练与评测语料,覆盖跨语言机器翻译、双语对齐与跨语言理解技术的全流程研发与应用需求。
从具体应用方向来看,该数据集可直接用于英土双向神经机器翻译模型的训练、评测及优化,帮助提升翻译系统对土耳其文这一突厥语系核心语言的翻译质量与场景鲁棒性,降低多语种翻译产品的研发门槛;也可支撑跨语言信息检索、双语词典构建、比较语言学研究等学术与产业场景,为面向英土跨境交流的多语种智能翻译终端、跨境电商智能客服、中土文旅智能导览、跨语言文献整理等产品提供算法验证与效果调优的基础数据支撑。
业内人士指出,本次英土平行语料数据集完成知识产权登记,一方面填补了当前国内合规小语种跨语言语料资源的供给缺口,为中土双边经贸、文化领域的数字化交流提供了基础数据支撑;另一方面也为国内AI训练数据类产品的知识产权确权、合规流通探索了可复制的实践路径,对推动人工智能数据要素赛道的规范化、市场化发展具有积极参考意义。
登记内容: