北京完成中蒙平行语料数据集知识产权登记 为小语种AI应用筑牢合规数据底座
当前随着我国数据要素市场化配置改革持续推进,数据知识产权登记作为明确数据权属、保障数据主体权益、规范数据流通交易的核心基础制度,已成为各领域数据资产化、商用化的必要前置流程。与此同时,伴随中蒙经贸往来、文化交流、跨境服务的不断深化,中蒙双语跨语言服务需求快速增长,但长期以来,高质量、合规可商用的中文-蒙古文平行语料资源供给不足,一直是制约中蒙跨语言AI能力落地的核心瓶颈。
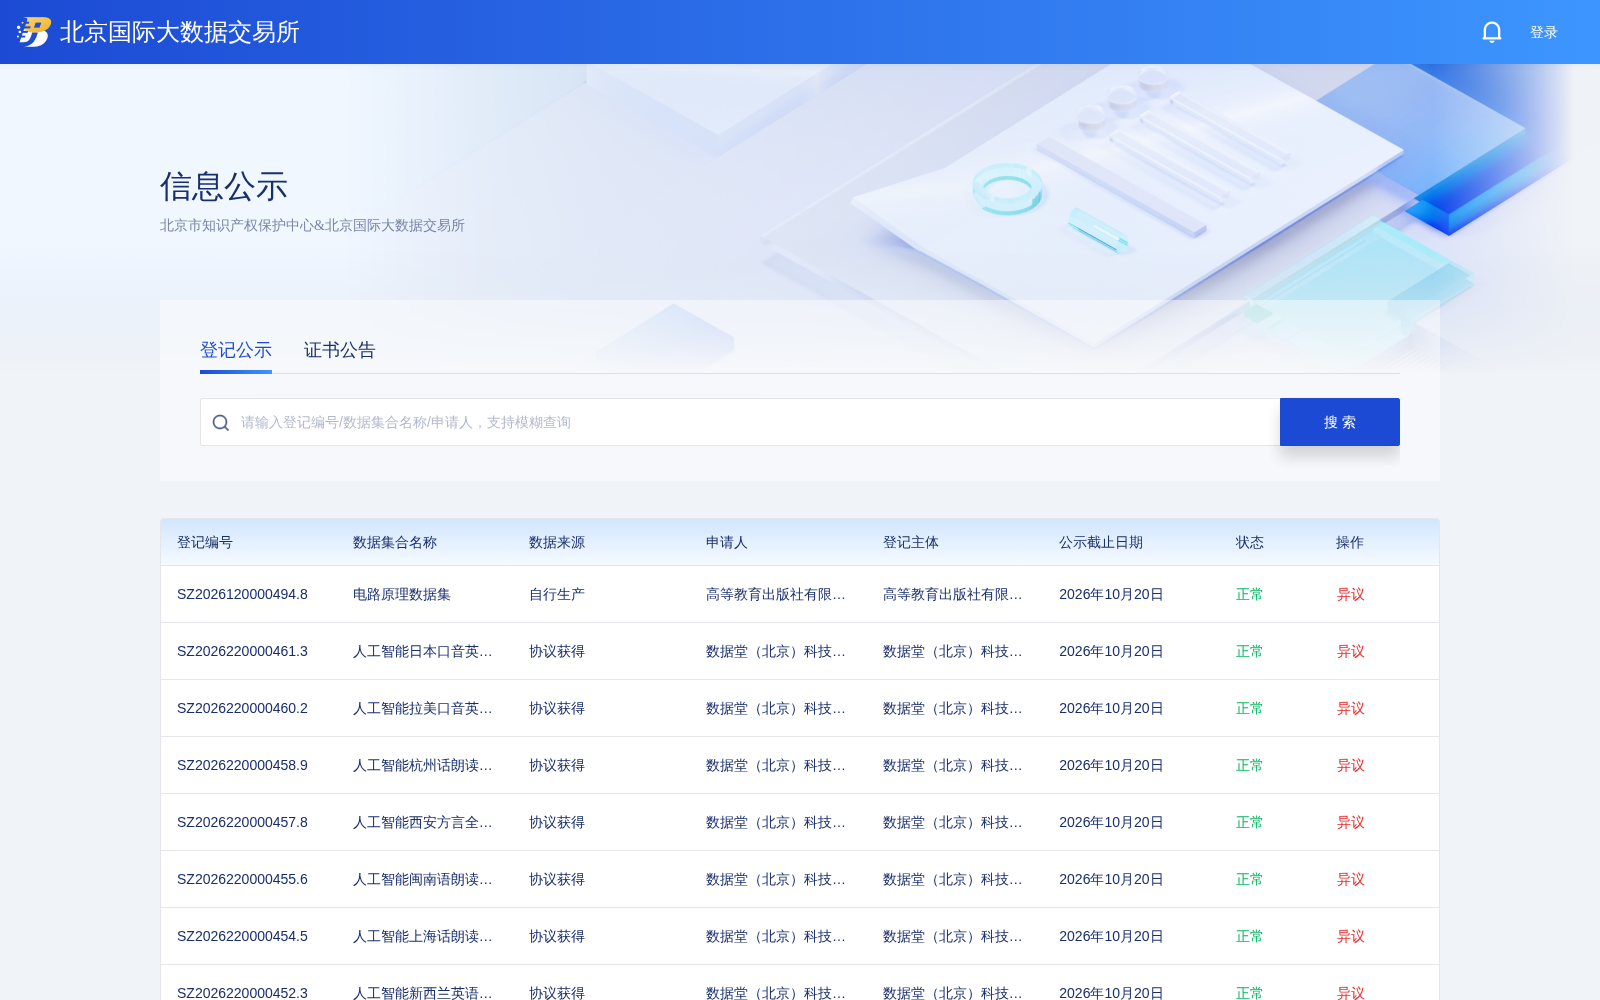
2026年9月30日,数据堂(北京)科技股份有限公司研发的人工智能中文-蒙古文平行语料文本数据集正式完成北京市数据知识产权登记,标志着该数据集的权属关系、合规性得到官方认定,为下游各类应用场景提供了可溯源、权益有保障的优质数据资源。
据介绍,本数据集可面向多类应用场景提供中文与蒙古文互译的能力支撑:
1)机器翻译模型训练:作为高质量的句级中文-蒙古文平行语料,可支撑统计机器翻译与神经网络机器翻译模型的训练、微调与评测,有效提升中蒙双向翻译在跨境医疗合作、国际新闻传播、科技成果交流、跨境旅游服务等专业领域的术语规范性与翻译准确率,解决传统人工翻译成本高、效率低的痛点;
2)翻译数据库建设:可为翻译记忆库、术语库与双语知识库的构建提供结构化的平行句对,支撑跨境电商商品本地化翻译、政务双语服务材料制作、专业文档翻译与跨语言检索等产品的底层数据积累,降低相关服务的开发门槛;
3)跨语言信息检索与内容理解:可为面向蒙古语市场的搜索引擎、新闻聚合平台、跨境舆情分析系统提供中蒙双语对齐语料,增强对蒙古文内容的语义理解与跨语言匹配能力,助力中资企业拓展蒙古国市场、中国文化内容面向蒙古国民众传播;
4)多语种大模型训练:作为非英语小语种的高质量平行语料,可为翻译大模型与多语种对话模型提供中文-蒙古文方向的预训练与对齐数据,有效增强大模型在小语种上的泛化能力与翻译鲁棒性,填补当前通用大模型中蒙双语能力不足的短板。
业内人士指出,本次中蒙平行语料数据集完成知识产权登记,不仅为中蒙跨语言数字服务领域提供了合规的核心数据资源,也为国内小语种垂直领域数据的资产化、流通化探索了可参考的路径,对助力中蒙俄经济走廊数字化建设、推动多语种数字经济融合发展具有重要的示范意义。
登记内容: