软著命名规范结构化数据集完成山东数据知识产权存证登记 覆盖四大行业应用场景
随着我国数字经济的快速发展,软件著作权作为科技企业核心无形资产的价值愈发凸显,与此同时,软著命名缺乏统一规范、版本关联混乱、侵权判定举证难等行业痛点也持续制约着知识产权服务的数字化转型。作为数据要素市场建设的重要基础设施,山东省数据知识产权存证登记平台主要承担数据知识产权的存证、登记、公示等职能,为合规数据资产的确权、流通、交易提供官方公信力背书,本次软著命名规范结构化数据集的登记,是知识产权垂直领域数据产品合规化的重要实践。
据了解,端点(陕西)科技有限公司本次登记的软著命名规范结构化数据集,针对当前软著全生命周期管理中的四类核心痛点设计,可覆盖四大典型应用场景,为相关领域的数字化升级提供量化支撑:
场景一:软著命名规范化研究。针对当前行业内软著构词模式缺乏共识、全称简称映射逻辑混乱、版本命名稳定性不足、分类维度混用四类普遍问题,该数据集通过构式标注、映射对记录、版本快照追踪及分类现状如实记录,为行业归纳主流命名构式、提取简称生成规则、追踪命名演化轨迹及重构统一分类维度提供量化基础,助力行业逐步形成统一的软著命名规范体系。
场景二:软件资产管理。针对企业、园区等主体普遍存在的软著产品无法精确标识、版本无法自动关联、单一检索维度易致漏检三个管理难题,该数据集以“全称+版本号”构建版本级唯一标识,以全称简称为分组键自动归集版本谱系,结合命名类型与功能关键词构建多维度检索体系,可帮助相关主体实现软著资产的精细化盘点,避免无形资产流失。
场景三:软著侵权判定辅助。在软著侵权纠纷处理中,通用词与独创词的界定、相似命名的混淆可能性判定一直是实务难点,该数据集通过统计主流构式分布为区分通用词与独创词提供行业基准,通过归纳简称构造典型模式为判定混淆可能性提供习惯性缩写实证参照,可辅助司法、行政及知识产权服务机构判断侵权方的攀附故意,提升纠纷处理效率。
场景四:自然语言处理训练语料。作为知识产权垂直领域的高质量标注短文本数据集,其可为大模型及NLP应用的训练提供三类核心语料:为命名实体识别提供软件作品名标注语料,为简称生成与还原提供序列到序列训练样本,为短文本分类提供带专业标签的领域数据,填补了知识产权垂直领域标注语料的供给缺口。
登记内容:
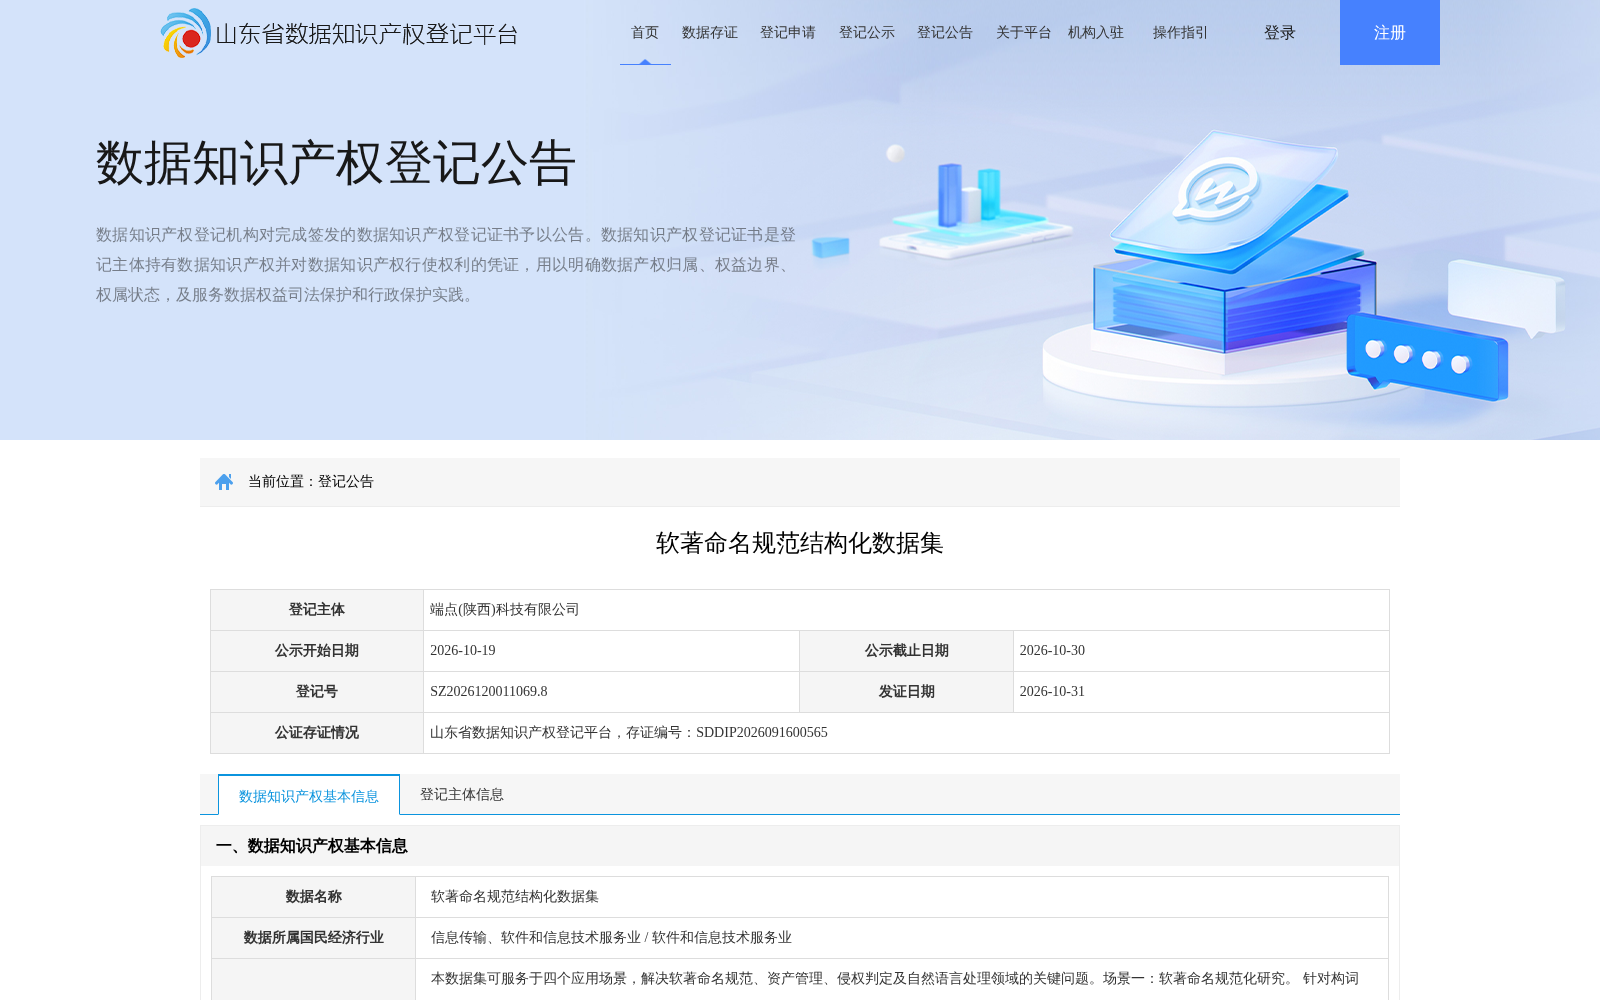
业内人士指出,本次软著命名规范结构化数据集的合规登记,为细分领域专业数据集的知识产权存证、流通应用提供了可借鉴的样本,也将进一步推动数据要素在知识产权服务、科技资产管理、司法辅助等领域的价值释放,助力数据要素市场的垂直化、场景化落地。