浙江人力资源服务问数垂类大模型语料完成数据知识产权登记 破解行业客户管理痛点
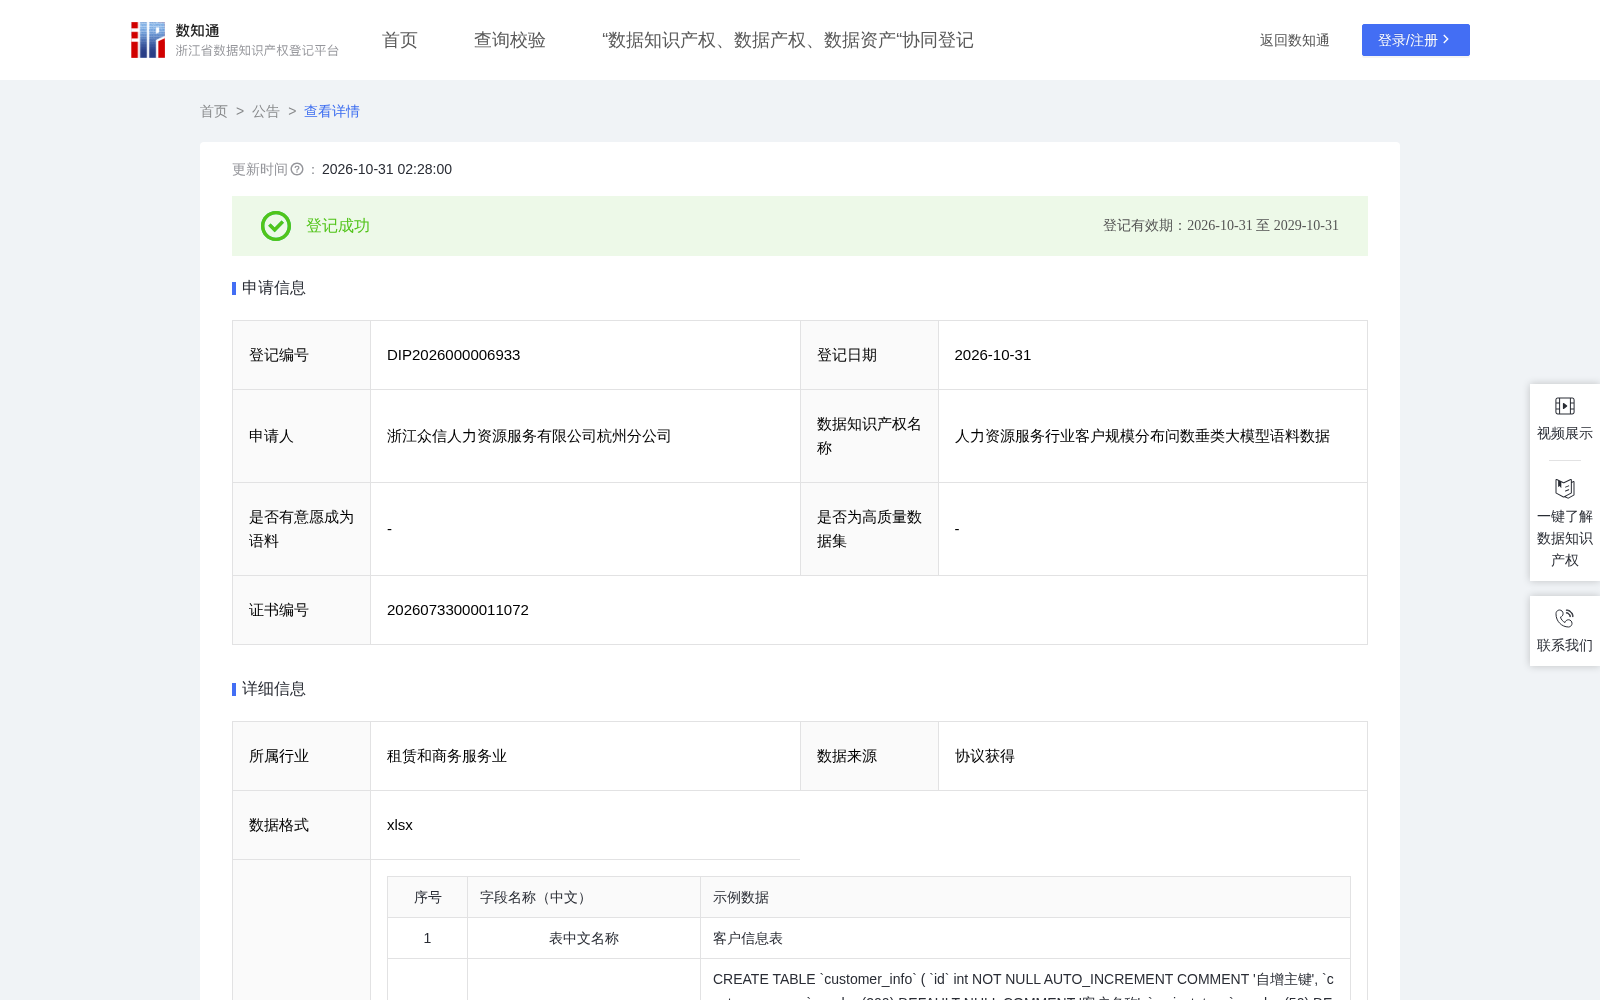
随着数据要素市场化配置改革持续深化,垂类大模型在各细分行业的应用落地提速,高质量、合规确权的行业专用标注语料,成为制约产业数字化转型的核心供给短板。作为浙江省推进数据资产确权、流通、保护的重要公共服务载体,浙江省数据知识产权登记平台为市场主体的数据知识产权提供官方登记、公示服务,为后续数据资产的交易、应用、维权提供合规依据。近日,浙江众信人力资源服务有限公司杭州分公司旗下的人力资源服务行业客户规模分布问数垂类大模型语料数据,正式在该平台完成数据知识产权登记。
当前人力资源服务行业在客户规模管理环节普遍存在多重数字化痛点:行业客户群体数量庞大且规模层级差异悬殊,管理层难以快速、精准掌握各层级客户的分布情况与服务资源占比;客户规模与项目类型、合作年限、区域分布等维度的交叉分析长期依赖人工汇总,不仅效率低下,还容易出现数据遗漏、统计口径不一致等问题;与此同时,目前行业内缺乏标准化的专用语料支撑大模型准确理解客户规模相关的自然语言查询需求,导致通用大模型在该场景下的应用准确率难以满足业务需求。
本次完成登记的语料数据,专为训练人力资源服务行业客户规模分布分析领域垂类大语言模型而构建,采用Text-to-SQL技术路径,围绕客户信息表构建自然语言到SQL的映射语料,覆盖规模层级统计、多维度交叉分析、TopN排名、阈值筛选、占比计算、趋势追踪等核心业务场景,可复用于人力资源服务机构、劳务派遣平台、企业客户管理系统的智能查询模块训练,有效提升大模型对人力资源服务客户规模分布领域的语义理解与查询生成能力,大幅降低客户管理决策的数据获取门槛。
为保障数据质量与合规性,该语料的生产建立了严格的全流程管控机制:一是数据采集与预处理环节,原始数据来源于公司开展第三方人力资源服务过程中采集的客户规模业务数据,涵盖客户规模层级、服务体量、合作年限、项目类型、区域分布等维度,经去重、异常值剔除、脱敏处理后,数据有效率≥98%,且不含任何个人身份信息,完全符合数据安全相关要求;二是问数需求分类环节,从客户管理业务系统收集真实问数需求,按规模统计、结构分析、排名查询、阈值筛选、趋势追踪等场景分类,标注规模层级与项目类型标签,覆盖客户规模分布分析90%以上核心问数需求,构建形成标准化基础问题集;三是SQL编写与结果核验环节,基于“业务术语-字段名”映射规则编写标准SQL,每条SQL经数据库执行验证并与原始数据比对,SQL正确率≥94%,再由资深业务专家对问题-SQL-结果三元组进行最终核验,确保语义对齐、数值准确,结果核验正确率≥97%;四是语料独立构建与迭代优化环节,本语料按“客户规模分布”单一专题独立构建,避免合并训练导致的模型学习权重被稀释问题,可显著提升模型在该场景下的专项理解与SQL生成准确率,同时建立“生成-校验-反馈-修正”闭环机制,定期补充边缘问句与缺失场景,形成可自进化的客户规模分布问数语料体系。
从行业层面来看,本次登记为人力资源服务领域的专业化数据资产确权提供了可参考的实践样本,既为数据提供方的知识产权保护提供了官方公信力支撑,也为后续该类垂类语料数据的合规流通、市场化交易奠定了基础。未来该语料可广泛应用于人力资源服务机构的客户分层运营、服务资源精准调度、客户需求预判等多个场景,对推动人力资源服务行业的数字化转型、丰富数据要素市场的细分品类供给具有积极意义。
登记内容: