澳门大学发布MicroPerf-Bench基准数据集 填补编码智能体系统级性能评测空白
澳门大学信息科学与计算学院于2026年10月21日在arXiv首发面向微服务端到端性能优化的编码智能体评测基准数据集MicroPerf-Bench,填补了该领域标准化评测工具的空白,将为智能编码工具迭代、云原生系统效能提升提供权威数据支撑。
澳门大学信息科学与计算学院于2026年10月21日在arXiv首发面向微服务端到端性能优化的编码智能体评测基准数据集MicroPerf-Bench,填补了该领域标准化评测工具的空白,将为智能编码工具迭代、云原生系统效能提升提供权威数据支撑。
东京大学联合日本产业技术综合研究所于2026年10月21日在预印本平台arXiv首发开源AT-DIFFER音频-文本差异描述数据集,该数据集首次系统性覆盖多类音频-文本语义差异场景,将为多模态大模型评测、文本到音频生成等领域的语义对齐校验提供标准化基准。
里昂第二大学联合日内瓦大学等机构于2026年10月21日在arXiv首发GuidedSAM-Plume火山羽流与云图像分割数据集,通过覆盖多场景的专家标注样本为火山参数反演、环境遥感等领域提供标准化数据支撑。
2026年10月22日,Meta旗下AI研究部门AI at Meta在HuggingFace首发英语评测数据集MemProBench,面向智能体记忆评测、第一人称视频情景记忆两大核心研发场景,为AI交互能力迭代提供标准化测试支撑。
全球知名非营利AI数据研究机构LAION eV于2026年10月22日在HuggingFace首发Humaneness-Voice-Large-1.2-Alpha-Demo-Audio数据集,采用CC BY 4.0开源许可,覆盖5种主流语言,可为多语言文本转语音合成、声音表演类AI的研发验证提供标准化演示资源。
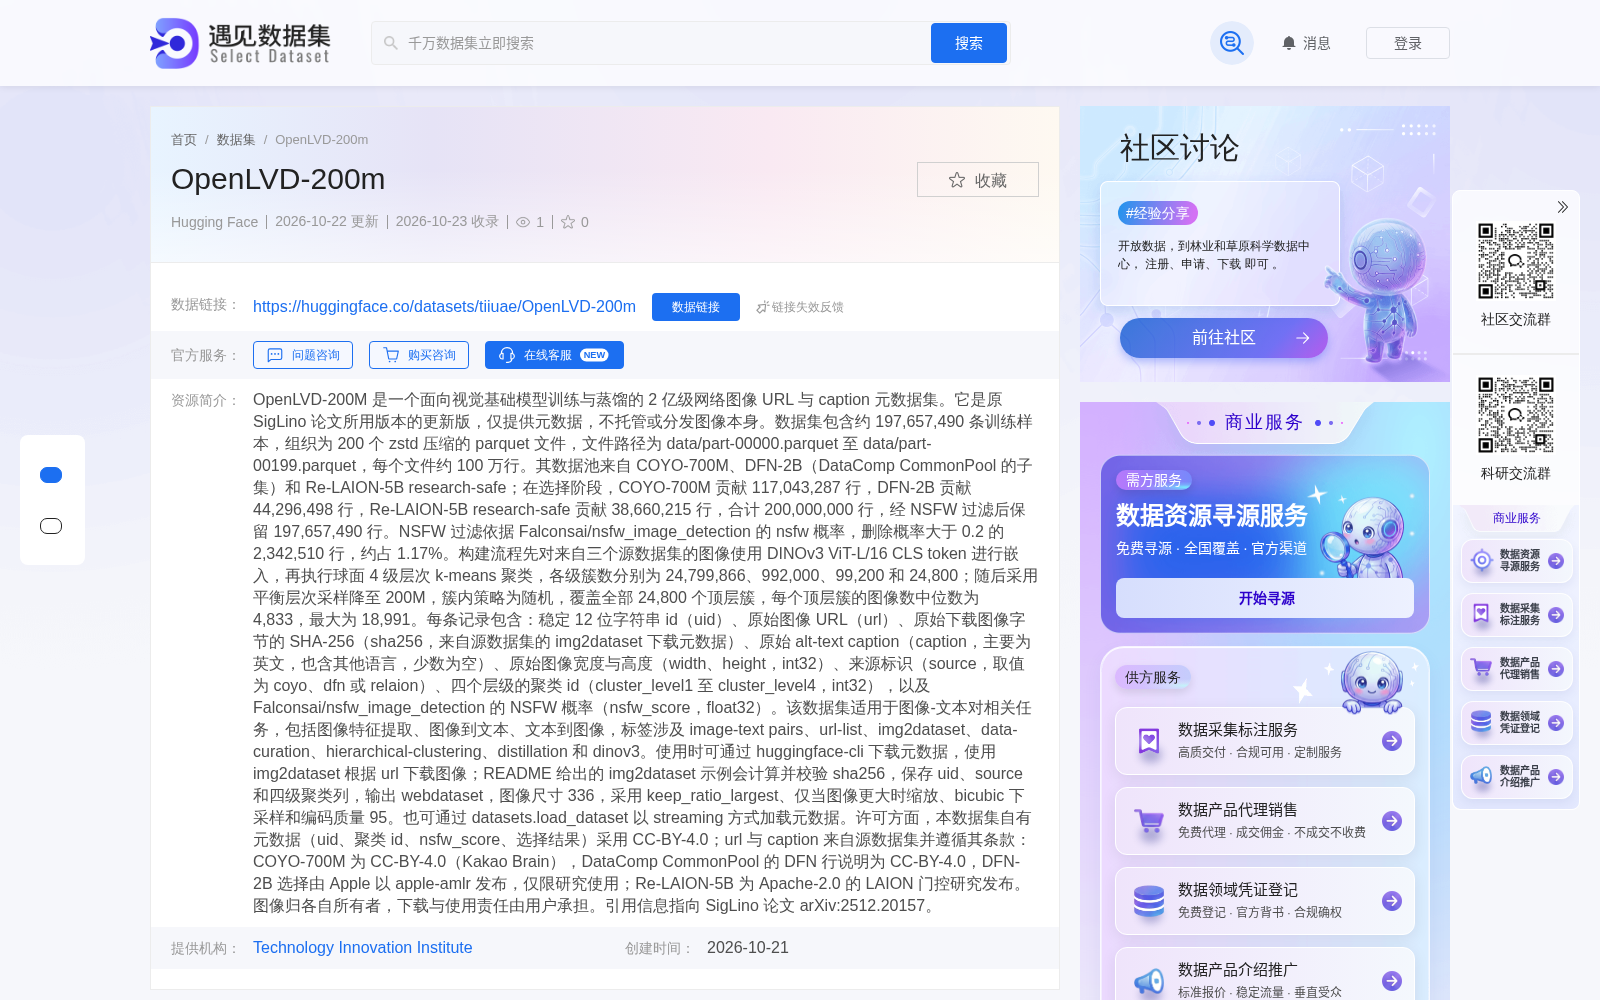
Technology Innovation Institute(简称TII)于2026年10月22日在HuggingFace首发2亿级图文元数据集OpenLVD-200m,作为SigLino论文所用数据集的升级版本,该数据集可广泛应用于视觉基础模型蒸馏、图文数据策展等多类多模态AI研发场景,为全球AI研究者提供了高质量、结构化的训练数据资源。
全球知名开源AI数据集机构LAION eV于2026年10月22日在Hugging Face首发Humaneness-Voice-Large-1.3-Alpha-Listening多语言语音数据集,采用CC BY 4.0开源协议,面向表达性文本转语音合成、情绪掩蔽听感评估场景设计,将为AI语音领域复杂情绪表达技术的研发提供标准化评测支撑。
全球知名AI开源社区Hugging Face于2026年10月22日正式发布funes-swe-chat-zh-e5智能体专属数据集,该数据集针对Agent记忆与召回场景优化,支持开发者无需本地构建索引即可直接调用会话数据,大幅降低中文编码类智能体的开发门槛。
2026年10月21日,Senecta公司在预印本平台arXiv首发面向跌倒筛查研究的eHomeSeniors低分辨率热成像公开数据集,为隐私友好型居家养老监护算法提供标准化训练与评估基准,填补了智慧养老领域低敏感公开数据集的供给空白。
加州大学伯克利分校FrontierCS团队联合多所高校及科研机构于2026年10月22日在预印本平台arXiv首发FrontierCS 2基准数据集,该数据集聚焦大语言模型科研智能体的真实代码贡献能力评测,填补了前沿科研场景下代码类基准的行业空白。
RealVV是浙江大学发布的数据集,于2026-10-22首发在arXiv应用于体积视频重建、受限采集退化模拟领域
AI训练数据集服务商Ropedia于2026年10月22日在学术平台arXiv首发多视角手-物交互数据集BiHOI,针对性解决行业长期存在的双手接触协调操作样本稀缺痛点,可为具身智能、人形机器人等领域的双手灵巧能力训练提供核心数据支撑。
东芝欧洲剑桥研究实验室于2026年10月20日在arXiv首发面向具身智能大语言模型的CAPSafe安全基准数据集,覆盖室内场景5大类41种安全风险,可实现智能体情境风险推断、长程安全规划能力的标准化评测,为具身智能商业化落地的安全验证提供核心数据支撑。
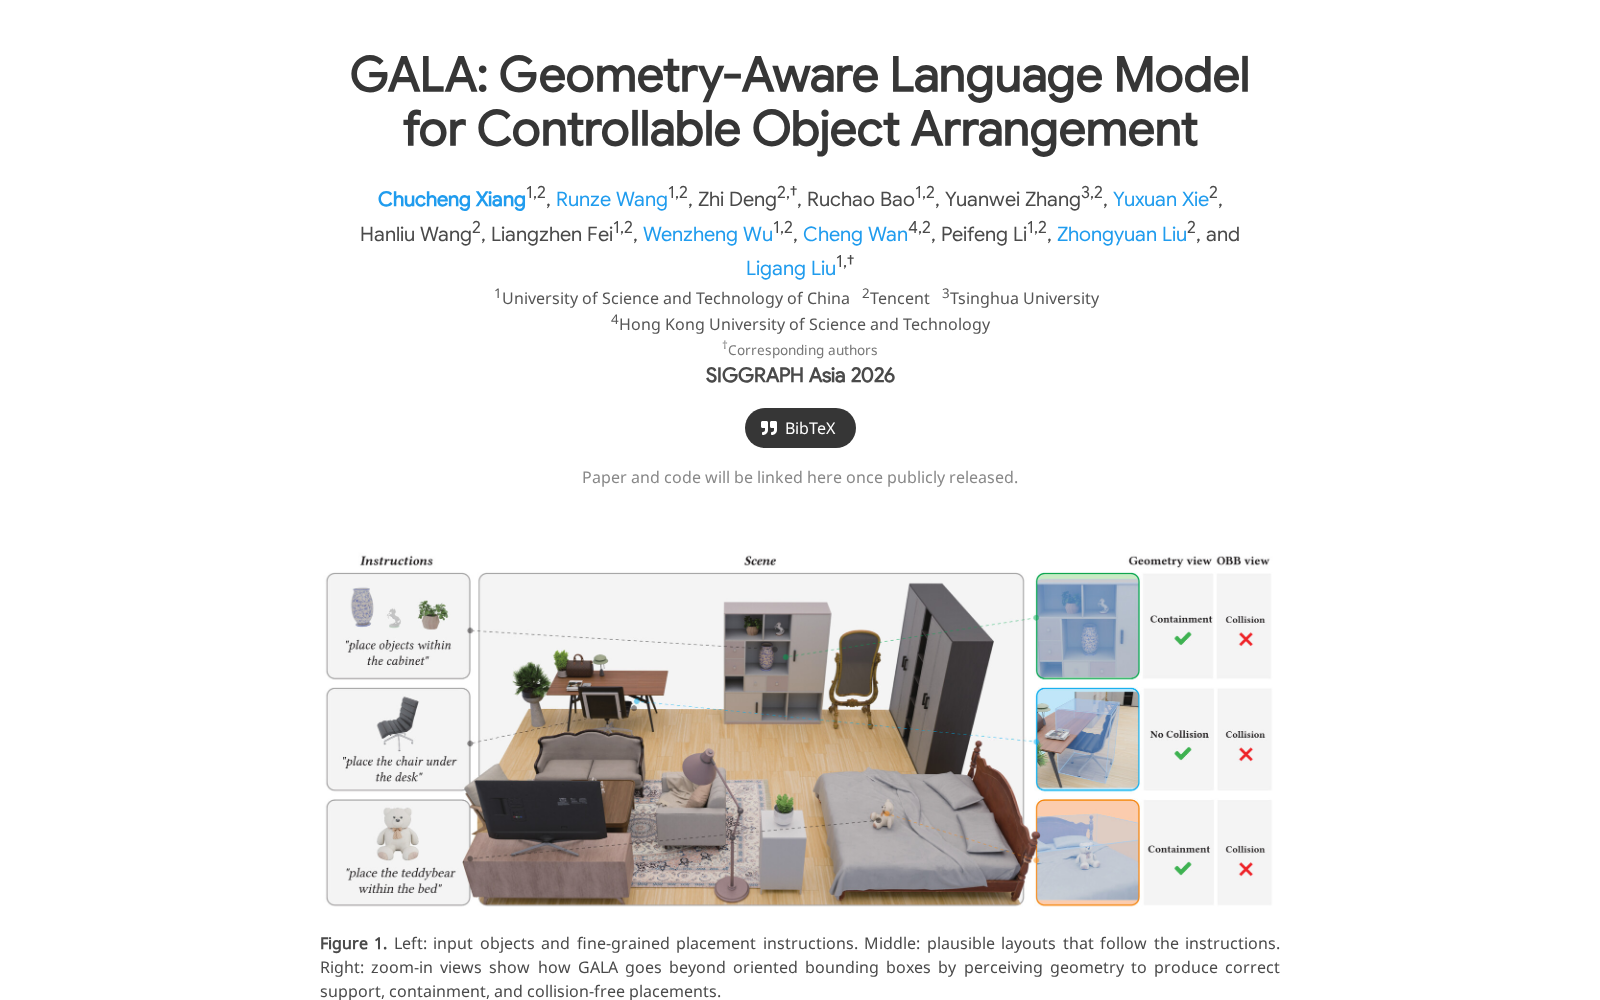
2026年10月20日,中国科学技术大学研究团队于预印本平台arXiv首发多源场景数据集(Multi-source Scene Dataset),该数据集包含28.5万条高精度标注样本,覆盖多类型室内场景与细粒度空间关系标注,可为可控三维生成、几何感知大模型训练评测提供标准化数据基准。
ABACUS是巴黎-萨克雷大学发布的数据集,于2026-10-20首发在arXiv应用于指令式图像编辑评估、目标计数编辑领域
美国普渡大学研究团队于2026年10月20日在arXiv平台首发动态RAG弃答基准数据集DECLINECRAFT,填补了检索文档与模型参数知识双重不足场景下的大模型能力评测空白,为提升生成式AI系统可靠性、治理大模型幻觉问题提供了标准化测试工具。
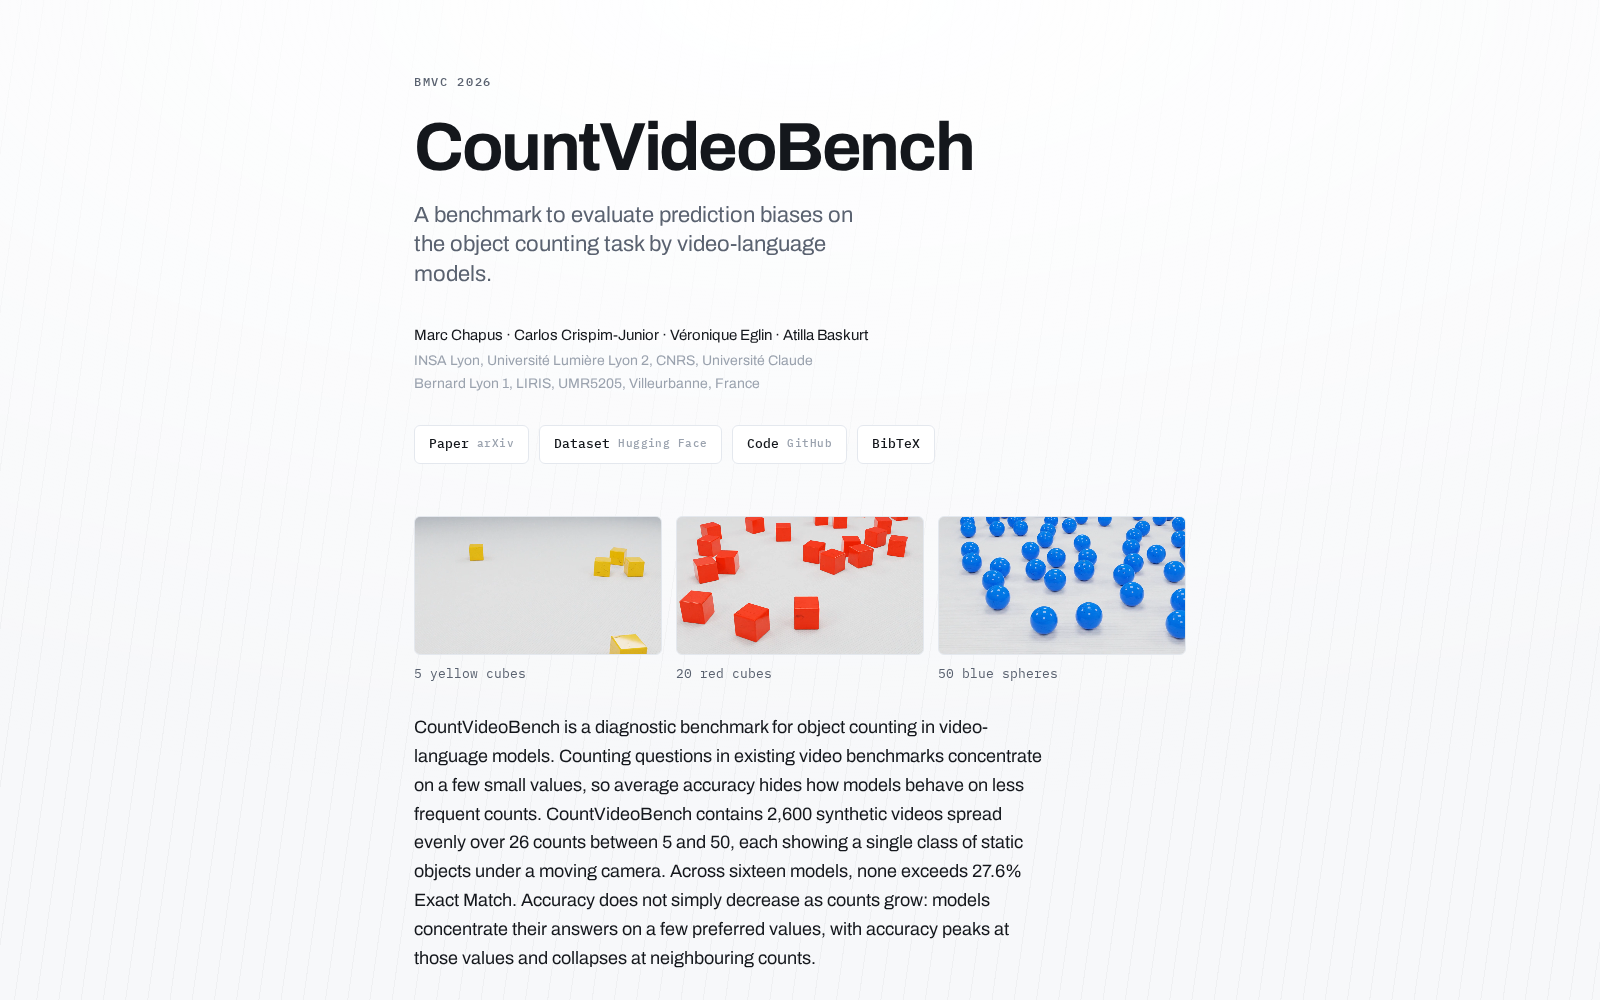
近日,由里昂国立应用科学学院牵头,联合法国多家顶尖科研机构依托LIRIS实验室打造的CountVideoBench视频目标计数诊断基准数据集于2026年10月20日首发于arXiv平台,可解决现有VideoQA计数基准分布偏斜的行业痛点,为视频语言模型零样本计数能力评测提供标准化支撑。
2026年10月21日,NVIDIA于Hugging Face平台正式首发RFD4-Proteina分子结构训练数据集,该数据集整合实验级PDB结构与AlphaFold DB预测结构资源,覆盖五大类生物分子数据,可支撑蛋白质设计、抗体研发、基因编辑工具优化等多个AI生物计算场景的研究与模型训练。
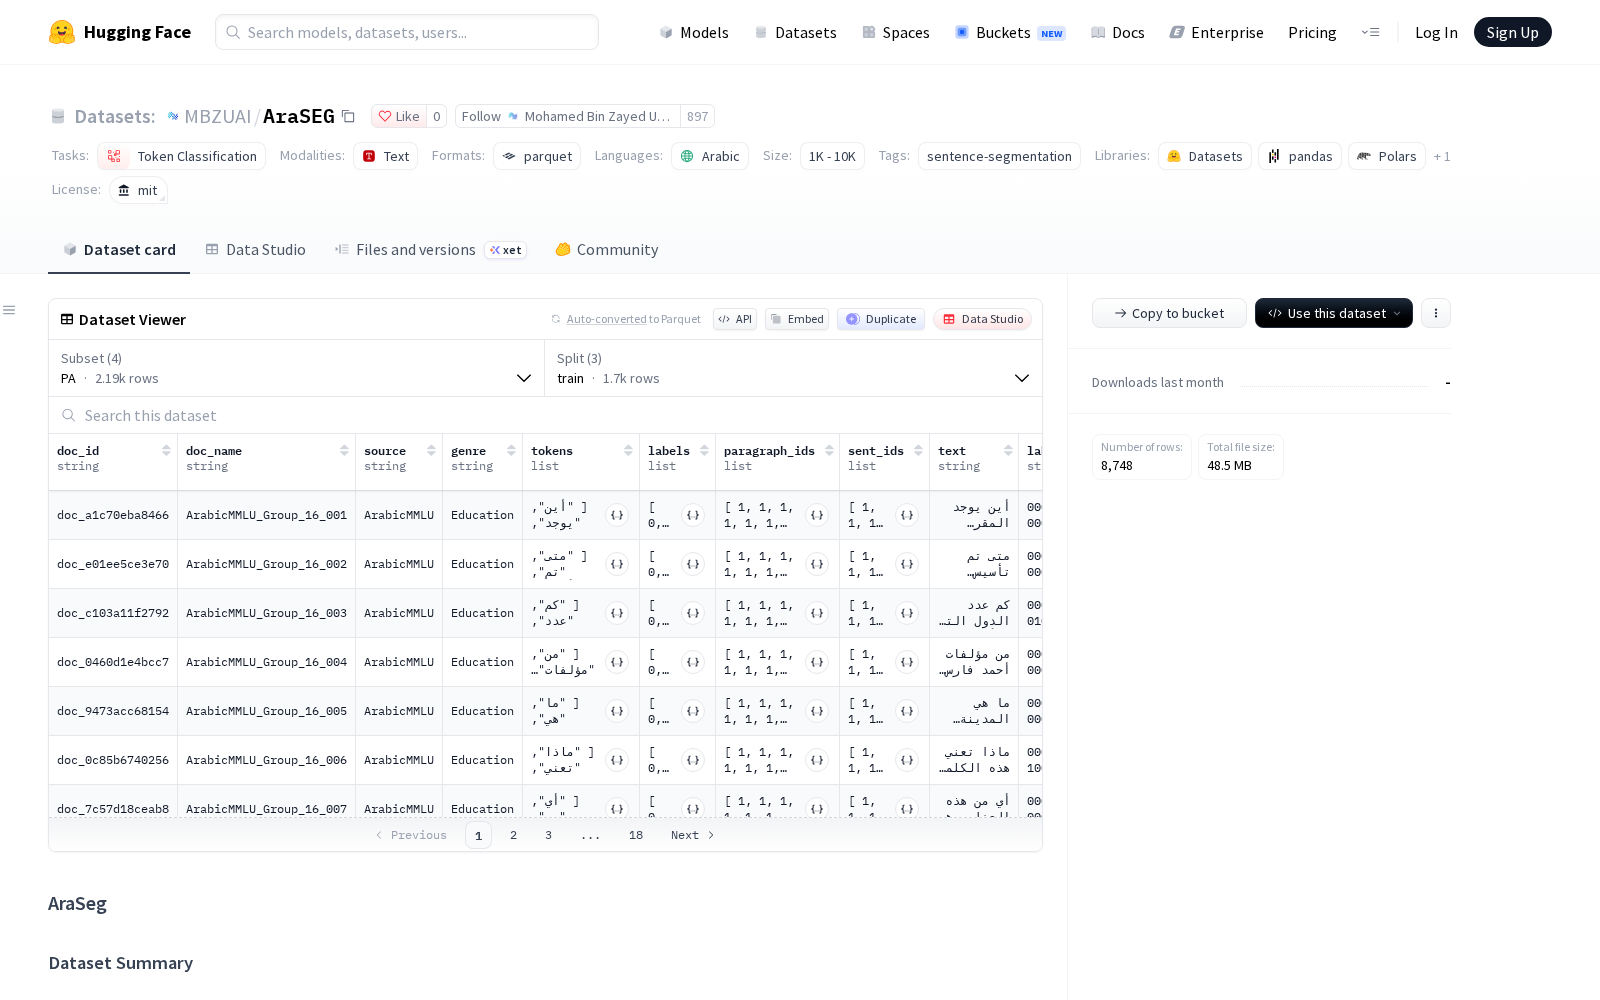
穆罕默德·本·扎耶德人工智能大学(MBZUAI)于2026年10月21日在HuggingFace平台上线手工标注跨体裁现代标准阿拉伯语句子切分基准数据集AraSEG,针对阿拉伯语标点稀疏歧义的语言特性适配多元真实场景,可为阿拉伯语自然语言处理全场景应用提供标准化底层支撑。
NVIDIA联合德国AI研究机构与初创企业联盟Soofi于2026年10月上线HuggingFace发布Nemotron-Personas-Germany数据集,作为首个对齐德国官方人口统计特征的德语合成人物数据集,可免费用于商业与非商业场景,将为德语大模型训练偏差缓解、合成数据生成、主权AI体系建设提供核心数据支撑。
面向社区/商业的数据集话题
面向高校/科研机构的开源数据集话题