挪威国家图书馆AI实验室发布布克莫尔语专用数据集 填补文档级形态风格转换训练数据空白
随着多风格文本生成、个性化内容改写等NLP应用需求快速攀升,低资源小语种领域的高质量标注训练数据缺口持续扩大,成为制约区域语言数字化服务发展的核心瓶颈。作为北欧语言数字资源建设的核心机构,挪威国家图书馆(Nasjonalbiblioteket)AI实验室长期专注于挪威语相关的NLP数据集研发、语言资产数字化治理工作,其发布的多个挪威语训练数据集已被广泛应用于北欧区域的智能翻译、智能写作等场景。
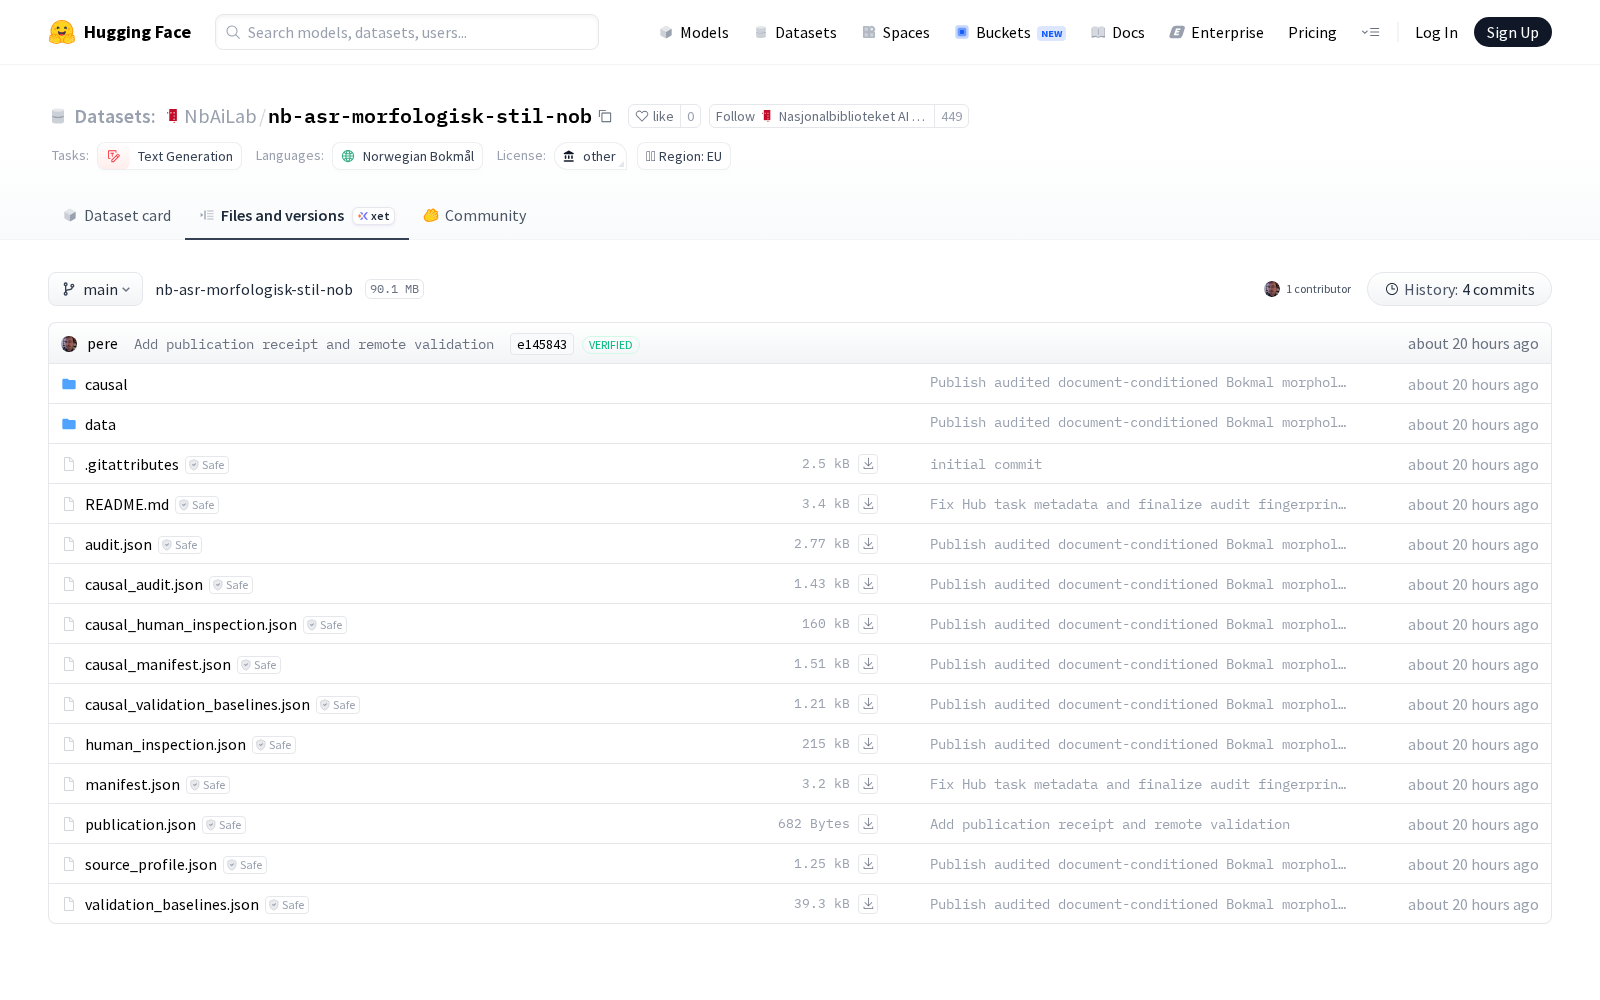
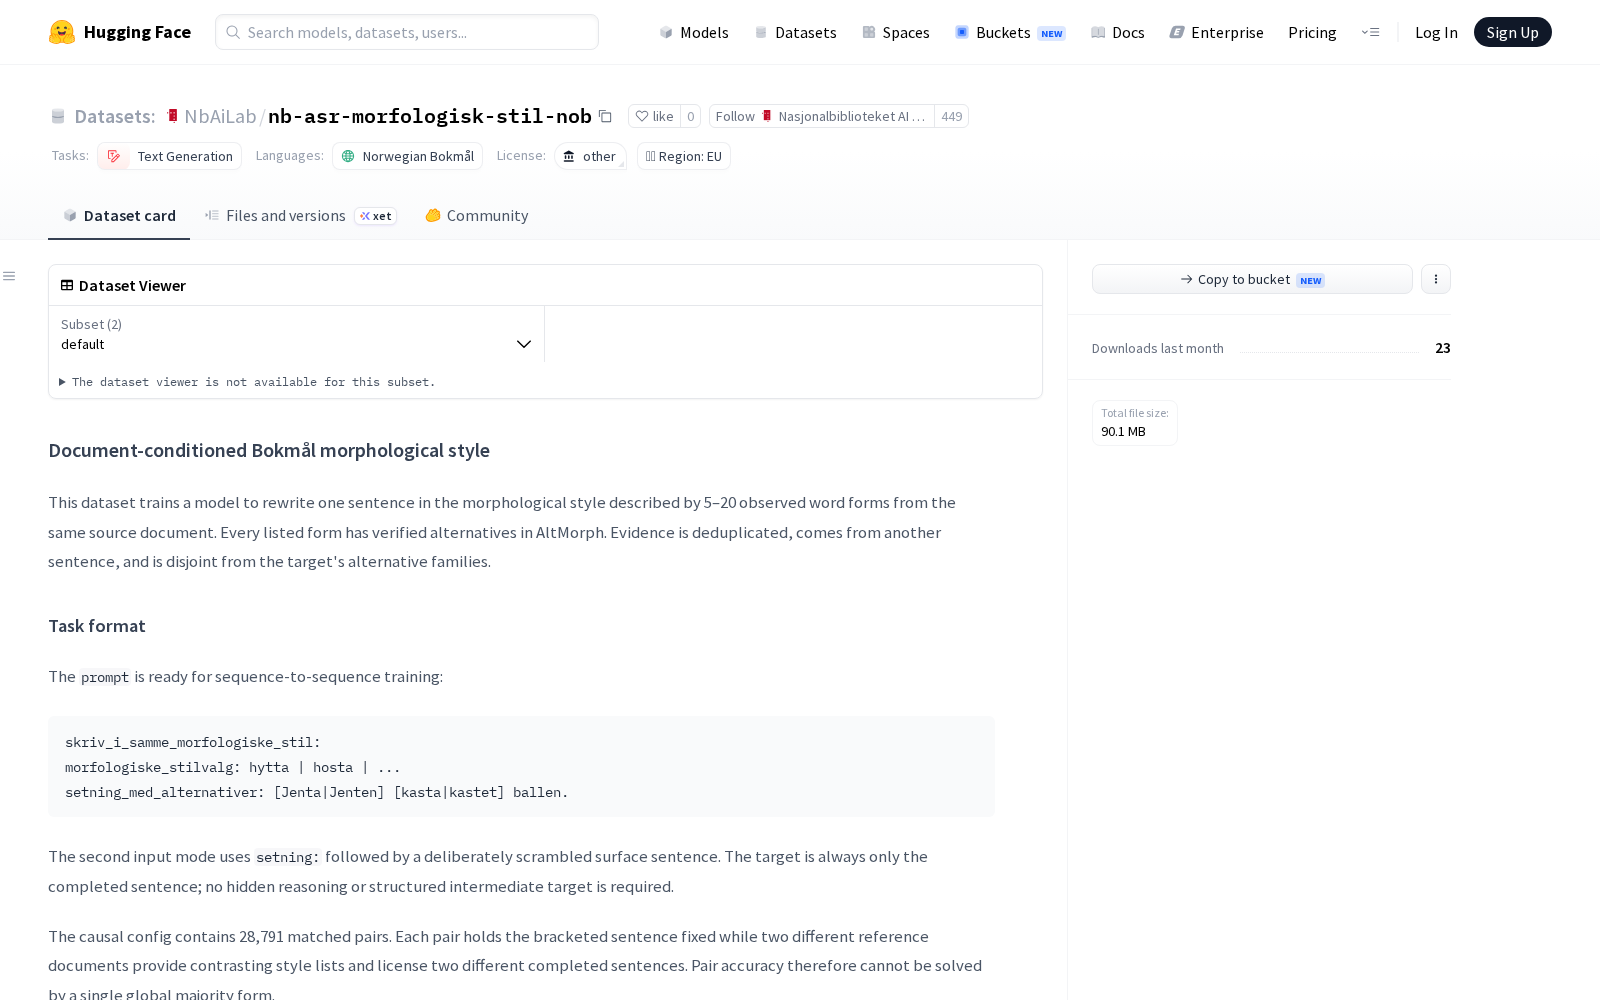
2026年9月5日,该实验室正式在HuggingFace上线全新nb-asr-morfologisk-stil-nob数据集,该数据集专为文档条件化的布克莫尔语形态风格转换任务设计,核心目标是训练模型根据同一源文档中观察到的5–20个词形(形态风格)特征,在保留语义不变的前提下完成句子重写,适配目标文档的整体风格。
据公开信息显示,该数据集的每个标注词形均在AltMorph数据库中有已验证的替代形式,所有替代形式的证据均来自独立句子,且与目标的替代家族不相交,确保了标注数据的准确性与无偏性。数据集整体采用序列到序列训练适配的提示格式,同时包含形态风格选择模块和带替代项的句子样本;此外还额外提供了因果配置(causal)子集,包含28791对匹配样本,样本中带括号的句子固定,通过两个不同的参考文档提供对比风格列表,可支撑模型生成两种不同风格的完整句子,满足对比训练、风格可控生成等研究需求。
整个数据集共包含396706行数据,源自84101个不同目标句子,按照近重复文档聚类哈希规则划分为训练集(327912行)、验证集(34032行)和测试集(34762行),从规则上避免了文档跨划分导致的数据泄漏问题,保障了模型训练效果的可信度。数据集底层源自NbAiLab/nb-asr-supermorphed-nob数据集,每行数据均保留原始来源、修订版本、文档标识符、来源类型和行级许可证,构建过程中替代块实现了与人工编写源文本的精确对齐,风格形式仅保留每个候选为单一词形的情况,同时完整保留文字Markdown、数学公式和编辑括号等特殊格式。每一行数据均包含每个风格形式的替代项和证据句子、目标家族元数据以及近重复聚类ID,同时随附manifest.json、audit.json、source_profile.json和human_inspection.json全套文件,为研究人员提供完整的可复现性支撑与检查记录。实验室特别提示,数据集中的风格列表为对应文档的证据特征而非全局一致的语言学标签,源文档可能存在引用、多作者或自然语言变异等情况,评估模型效果时应分开报告带括号和打乱模式的结果,并与基于规则和未改变的基线进行对比,保障评估结果的科学性。
从应用价值来看,该数据集可广泛支撑多个领域的NLP应用落地:在出版行业,可用于训练风格统一模型,自动将不同作者的投稿内容调整为符合出版社规范的语体风格,降低人工校对成本;在历史文献数字化领域,可支撑模型将采用旧形态规则的布克莫尔语历史文献,转换为符合现代使用习惯的文本形态,同时保留原文档的风格特征,提升历史文献的可读性与传播性;在大模型微调场景中,该数据集可填补通用大模型在布克莫尔语风格生成能力上的短板,提升大模型在北欧语言场景下的智能写作、个性化内容生成效果。
从行业意义来看,本次发布的数据集不仅填补了布克莫尔语文档级形态风格转换领域的训练数据空白,其“无数据泄漏划分、全链路可追溯、配套完整审计文件”的构建范式,也为其他低资源小语种的同类数据集研发提供了参考,对推动全球多语言数字资源平等建设、支撑小语种区域的语言服务数字化转型具有积极意义。
Dataset card内容:
Files and versions内容: