LAION eV发布六任务重平衡语音DPO数据集 开源赋能TTS偏好优化研发
作为全球开源AI训练数据领域的核心贡献机构,LAION曾凭借LAION-5B等数据集为Stable Diffusion等多模态大模型的发展提供了关键底座支撑,其发布的开源数据产品始终是全球AI研发领域的重要参考。随着生成式AI应用的快速落地,语音合成(TTS)的体验升级成为消费级AI应用、智能交互、数字人等赛道的核心需求,而直接偏好优化(DPO)作为当前AI模型对齐人类偏好的主流技术路径,语音领域的高标注DPO训练资源一直处于供给不足的状态,极大制约了中小团队的语音AI研发效率。
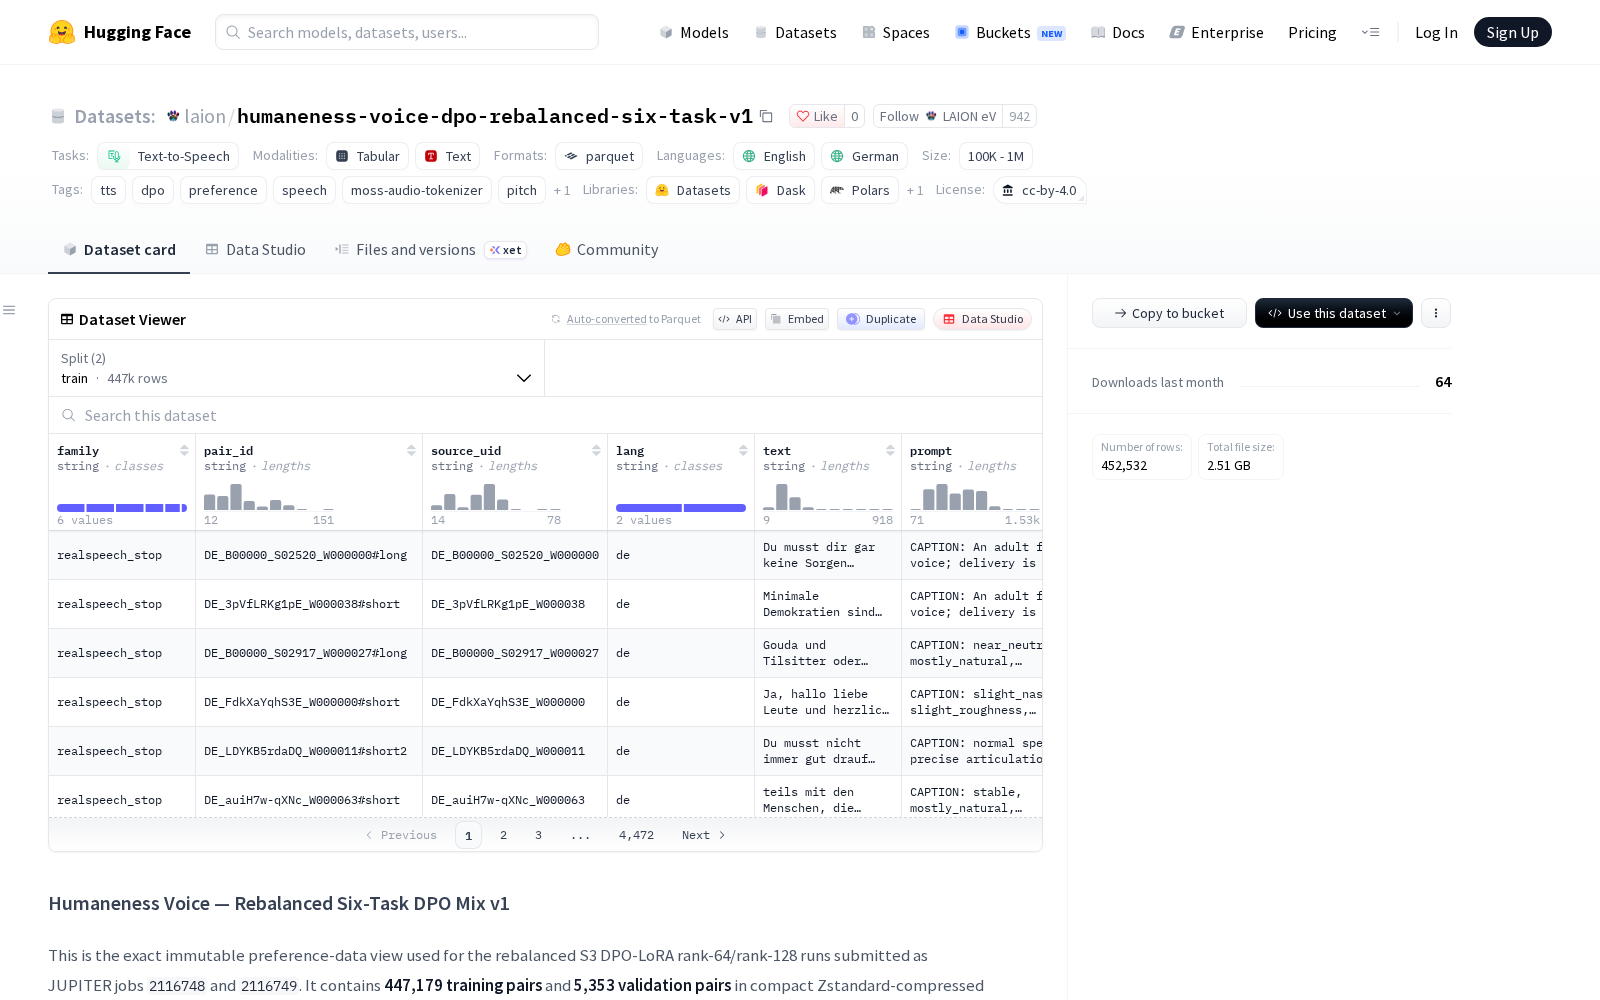
2026年9月30日,LAION eV正式在HuggingFace上线全新语音类数据集humaneness-voice-dpo-rebalanced-six-task-v1,全称为“Humaneness Voice — Rebalanced Six-Task DPO Mix v1”,是业内首个覆盖六大任务场景的开源重平衡语音DPO训练混合集。该数据集包含总计447,179个训练偏好对和5,353个验证偏好对,采用Zstandard压缩的Parquet分片文件存储,兼顾了高压缩率与训练时的快速读取能力,适配大模型批量训练的算力需求。
本次发布的数据集所有标注对来自六大任务家族,分别对应不同的语音优化方向:10万组realspeech_stop对应语音停顿自然度偏好、10万组voice_emotion对应语音情绪匹配度偏好、10万组voice_truncation对应语音截断流畅度偏好、55995组cfg_p2_length对应语音长度与文本内容匹配度偏好、66805组s5_pitch对应语调自然度偏好、24379组quality_repair_sidon对应语音音质修复效果偏好。每个样本包含chosen(人类偏好选择)和rejected(人类偏好排除)两种音频的MOSS Audio Tokenizer V2代码块(小端uint16数组,每80毫秒帧对应12个码本值),同时配套家庭标签、对ID、源UID、语言、对应文本、生成提示等完整元数据,所有音频由MOSS V2解码器生成,不包含原始波形,可直接适配当前主流大语音模型的输入范式。
从应用价值来看,该数据集主要用于训练文本转语音(TTS)系统中的偏好优化模型,可支撑多个领域的语音AI研发:比如消费级TTS工具的拟人化升级、有声书与AI配音的情绪适配优化、智能客服的语音自然度提升、虚拟数字人的语音输出对齐、多模态大模型的语音模块训练等,CC-BY-4.0的开源许可也允许开发者在署名的前提下进行商业使用,大幅降低了相关研发的准入门槛。
LAION同时提示了数据集的使用边界:s5_pitch任务存在严重的质量混淆,不应作为纯说话人身份数据集使用;验证集仅覆盖四个任务家族,缺少s5_pitch和quality_repair_sidon的验证对,开发者使用时需针对性调整验证逻辑。
从行业发展维度来看,本次数据集的发布是开源数据赋能AI产业升级的典型案例,填补了多任务语音DPO训练数据的市场空白,对于完善语音AI领域的开源数据供给体系、推动数据要素在生成式AI赛道的流通应用、加速语音合成技术的普惠化落地都具有重要意义。
查看humaneness-voice-dpo-rebalanced-six-task-v1
Dataset card内容:
Files and versions内容: