ESPnet发布20TB级Bagpiper多模态音频预训练数据集 首发HuggingFace覆盖全场景音频AI研发
近年来,随着多模态大模型、生成式音频AI技术的快速迭代,高质量、多品类、标注完善的预训练数据已成为音频AI研发的核心基础资源。作为全球语音AI领域广泛使用的主流开源工具链,ESPnet长期为行业输出基准数据集、算法工具等核心支撑,近期其在音频预训练数据供给端再次推出重要成果。
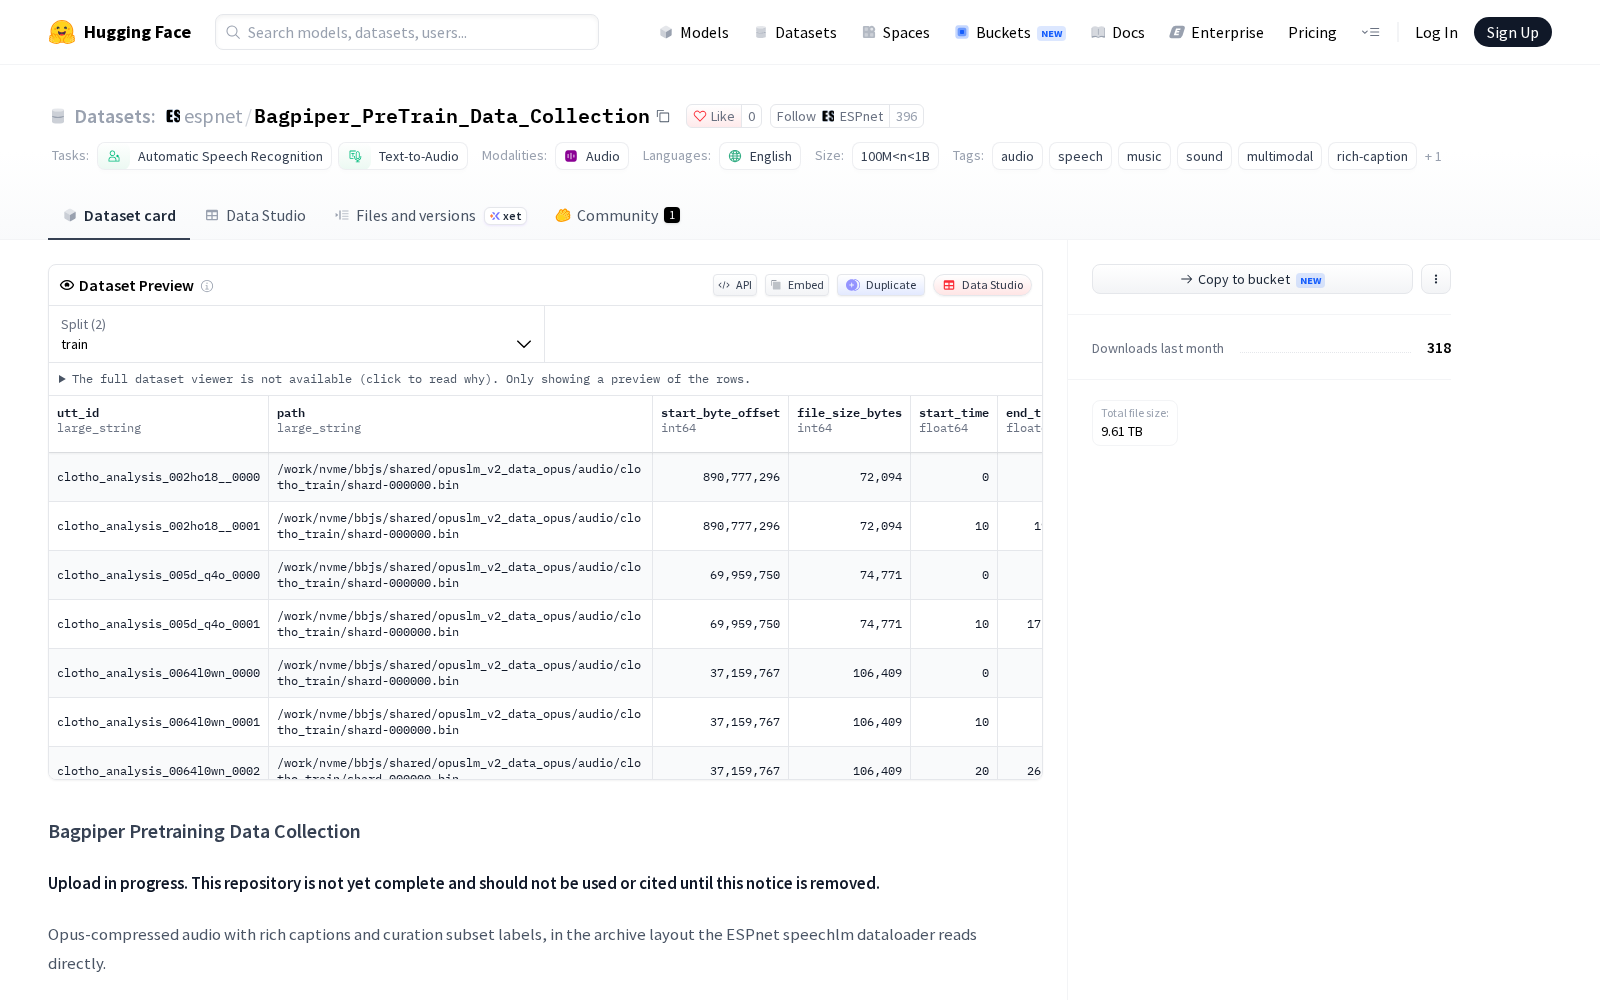
ESPnet本次发布的数据集Bagpiper_PreTrain_Data_Collection,全称为Bagpiper Pretraining Data Collection,是面向通用音频预训练场景打造的大规模多模态音频数据集。该数据集采用Opus压缩格式存储,包含约20TB的16kHz单声道Ogg/Opus音频,码率约32kbps,样本总量介于1亿到10亿之间,覆盖英语语种,可满足不同参数规模音频大模型的预训练数据需求。
与普通音频数据集不同,Bagpiper数据集的每个音频片段均附带纯文本格式的丰富标题(rich caption),同时按照应用场景划分了7大策展子集类别,分别对应speech_und(语音理解)、speech_gen(语音生成)、sound_und(声音理解)、sound_gen(声音生成)、music_und(音乐理解)、music_gen(音乐生成)6大基础方向及对应的监督微调(SFT)规模变体,单个音频片段可归属0个、1个或2个基础子集,方便研发人员根据自身任务需求灵活调取对应类别的数据子集,无需额外做数据分类标注,大幅降低数据预处理成本。
从应用场景来看,该数据集可覆盖自动语音识别(ASR)、文本到音频生成(TTS)、多模态音频理解与生成等主流音频AI研发任务:在语音赛道,可用于支撑语音识别、口语理解、个性化语音合成、情感语音生成等C端消费级产品与B端企业级服务研发;在通用声音赛道,可助力环境音识别、工业故障音频预警、场景音效生成等行业数字化应用落地;在音乐赛道,可服务于音乐分类、音乐标签生成、AI作曲、音乐风格迁移等内容创作方向的模型训练,为音频AI技术的全场景落地提供高质量数据底座。当前我国数据要素市场建设持续推进,AI训练数据作为重要的数字生产要素,其供给能力直接影响AI产业的发展速度,ESPnet本次推出的大规模多模态音频数据集,不仅为全球音频AI研发者降低了数据获取门槛,也为多模态训练数据集的标准化标注、分类体系建设提供了参考样本,助力音频大模型技术的普惠化发展。
截至目前,该数据集仍在平台上传过程中,完整的数据集卡片、统计信息和官方用法说明将在全部内容上传完成后同步公布,研发人员可提前关注相关更新动态。
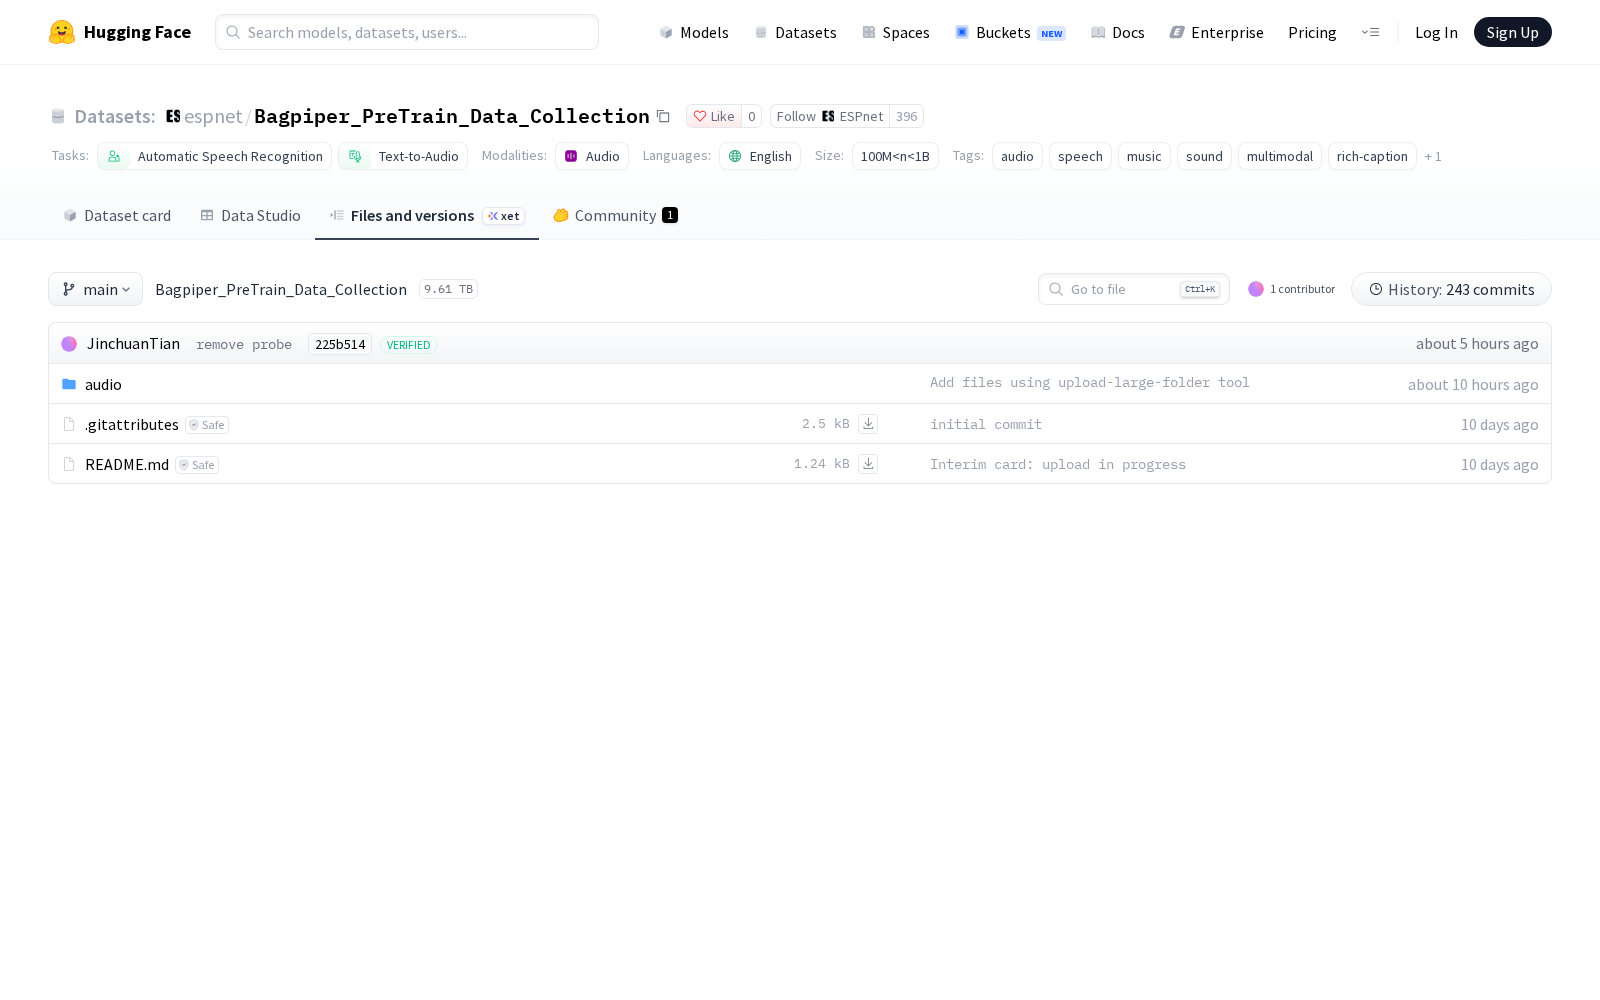
查看Bagpiper_PreTrain_Data_Collection
Dataset card内容:
Files and versions内容: