LAION eV发布TTS表演评估专用数据集 标准化支撑DPO微调效果跨模型对比
作为全球开源AI数据集领域的标杆机构,LAION eV此前因支撑Stable Diffusion等现象级生成式AI模型的训练数据供给受到行业广泛认可,其发布的公开数据集始终以标准化程度高、对照性强、贴合前沿技术研发需求为核心特点,是全球AI研发团队的重要基础资源。近年来,随着生成式语音(TTS)技术在虚拟人配音、有声内容生产、智能座舱交互、有声读物制作等场景的落地加速,直接偏好优化(DPO)已经成为语音大模型对齐人类听觉偏好、提升表演性表达效果的核心微调技术,但行业长期缺乏统一的标准化评估基准,不同团队的DPO微调效果难以实现公平横向对比,也大幅提升了TTS模型迭代的测试成本。
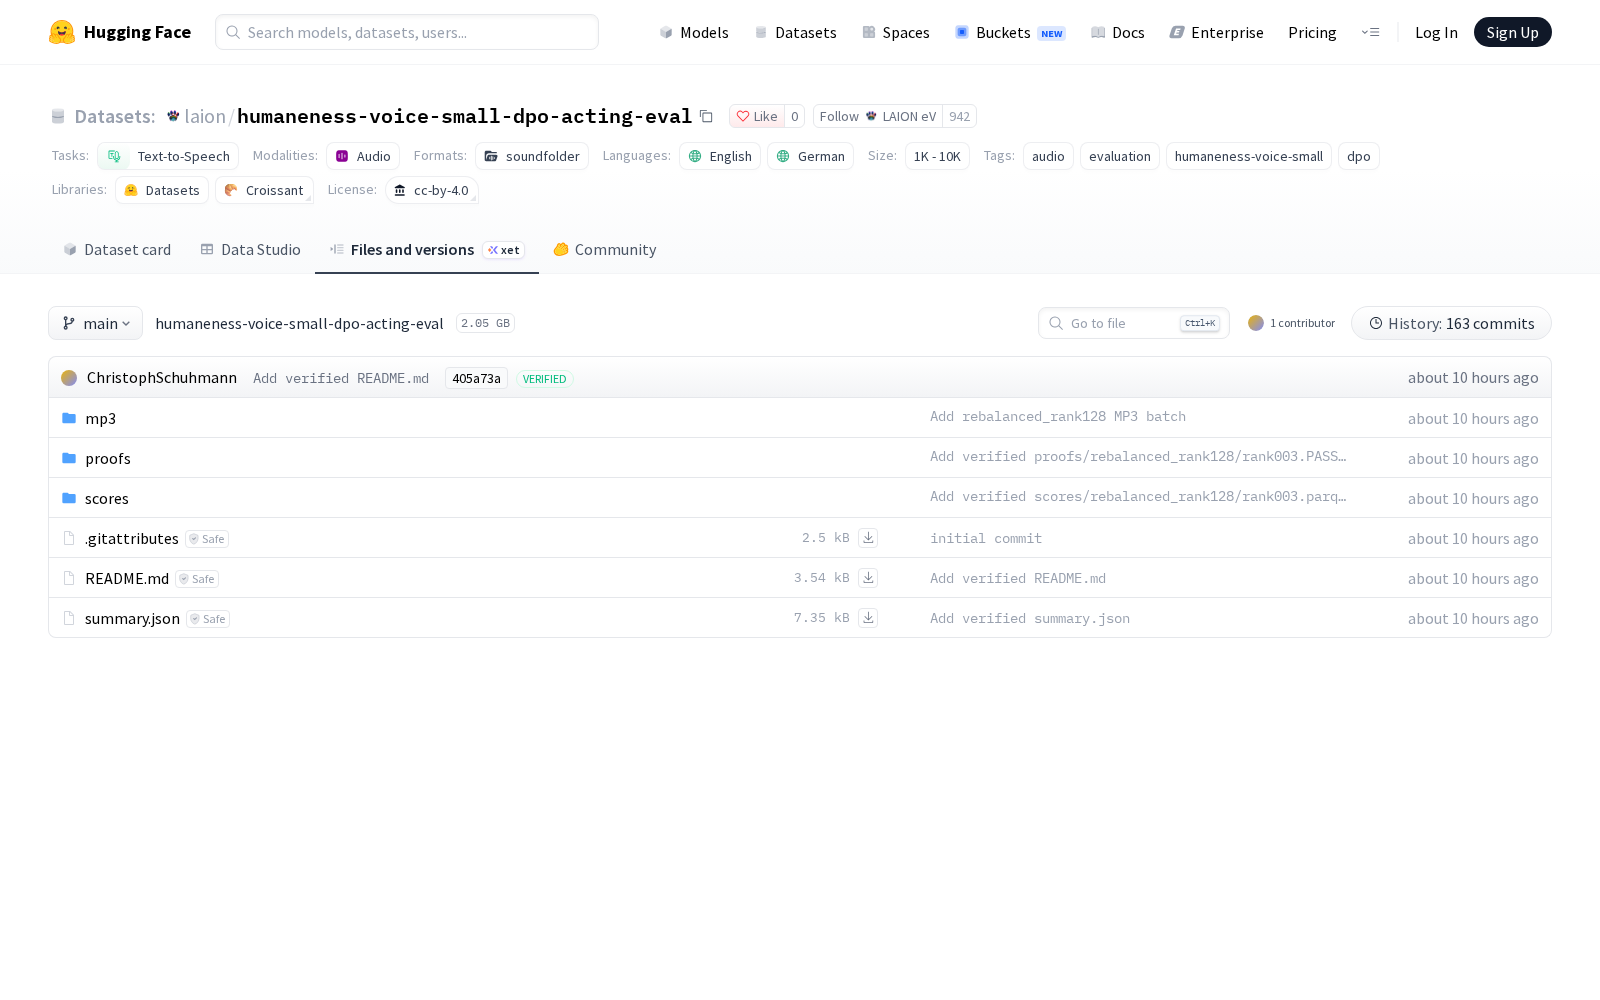
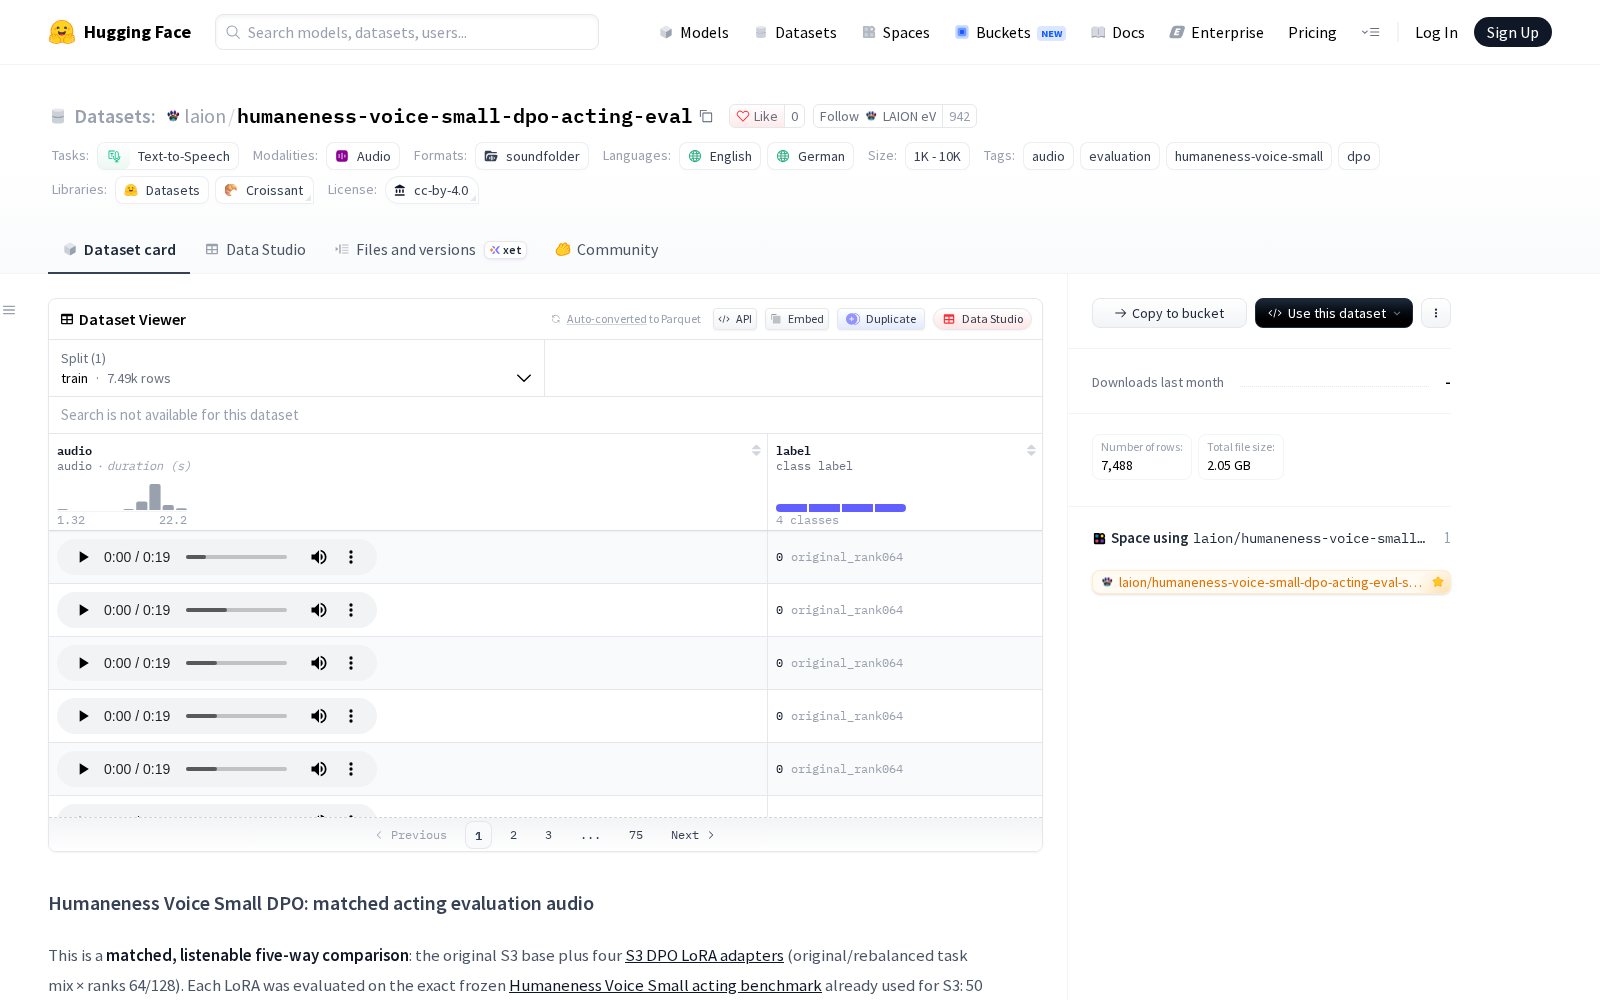
LAION eV本次发布的数据集humaneness-voice-small-dpo-acting-eval,即Humaneness Voice Small DPO 匹配表演评估音频数据集,正是瞄准这一行业痛点推出的专用评估资源。该数据集是专门面向文本到语音(TTS)模型评估打造的标准化音频集合,提供了S3基础模型与其四个S3 DPO LoRA适配器之间的可听五路比较体系。每个适配器均在固定的Humaneness Voice Small acting benchmark上完成评估,该基准覆盖50个应用场景、11种提示条件,同时包含英语和德语两种语言,所有样本均使用相同的脚本、提示、参考分配和生成种子,彻底排除了测试变量干扰。每个模型对应1872个匹配片段,四个LoRA适配器合计贡献了7488个可直接访问的128 kbps单声道MP3文件,数据集的比较键设定为(challenge_id, surface, mode, seed),MP3文件路径结构清晰可溯源。此外,数据集还包含scores目录下的16个Parquet文件和summary.json,可提供ASR/WER、真实性、情感向量等多维度量化评估指标,同时配套proofs目录中的不可变记录,保障评估过程的可追溯性。
从行业应用价值来看,该数据集可覆盖多类核心需求场景:对于TTS技术研发厂商,可基于该数据集的统一基准,快速验证不同DPO微调策略对虚拟主播配音、有声书演绎等场景下的语音表现力提升效果,减少自研测试集的人力与时间投入成本;对于语音AI领域的学术研究团队,可依托其标准化的对照样本体系,开展DPO优化算法、语音情感对齐、多语种语音生成等方向的横向对比研究,提升实验结论的普适性;对于第三方AI评测机构,可结合该数据集提供的多维度量化指标,搭配人工试听流程,搭建更具公信力的TTS模型性能评估体系。该数据集适用于TTS模型的性能比较、DPO微调效果分析以及自然度评估,但需注意预测指标存在局限性,应结合人工试听进行最终判断。
该数据集的发布,是开源数据领域针对生成式语音技术前沿需求的重要供给补位,将进一步降低TTS技术的研发门槛,推动语音生成产业的规范化迭代,也为数据要素支撑AI产业创新提供了典型实践样本。
查看humaneness-voice-small-dpo-acting-eval
Dataset card内容:
Files and versions内容: