东京科学大学首发不完整软件变更经验数据集 填补软件缺陷分析领域真实场景数据空白
随着全球软件产业迭代速度持续加快,开源协作模式下的代码变更复杂度呈指数级上升,因跨模块关联变更遗漏导致的隐性缺陷,已经成为影响软件交付质量、引发开源供应链风险的核心诱因之一。长期以来,软件工程领域针对变更影响分析工具、缺陷修复算法的性能评测,大多依赖人工模拟生成的不完整变更数据,与真实生产场景中代码变更的关联逻辑、缺陷诱发规律存在明显偏差,制约了相关技术的落地适配效率。
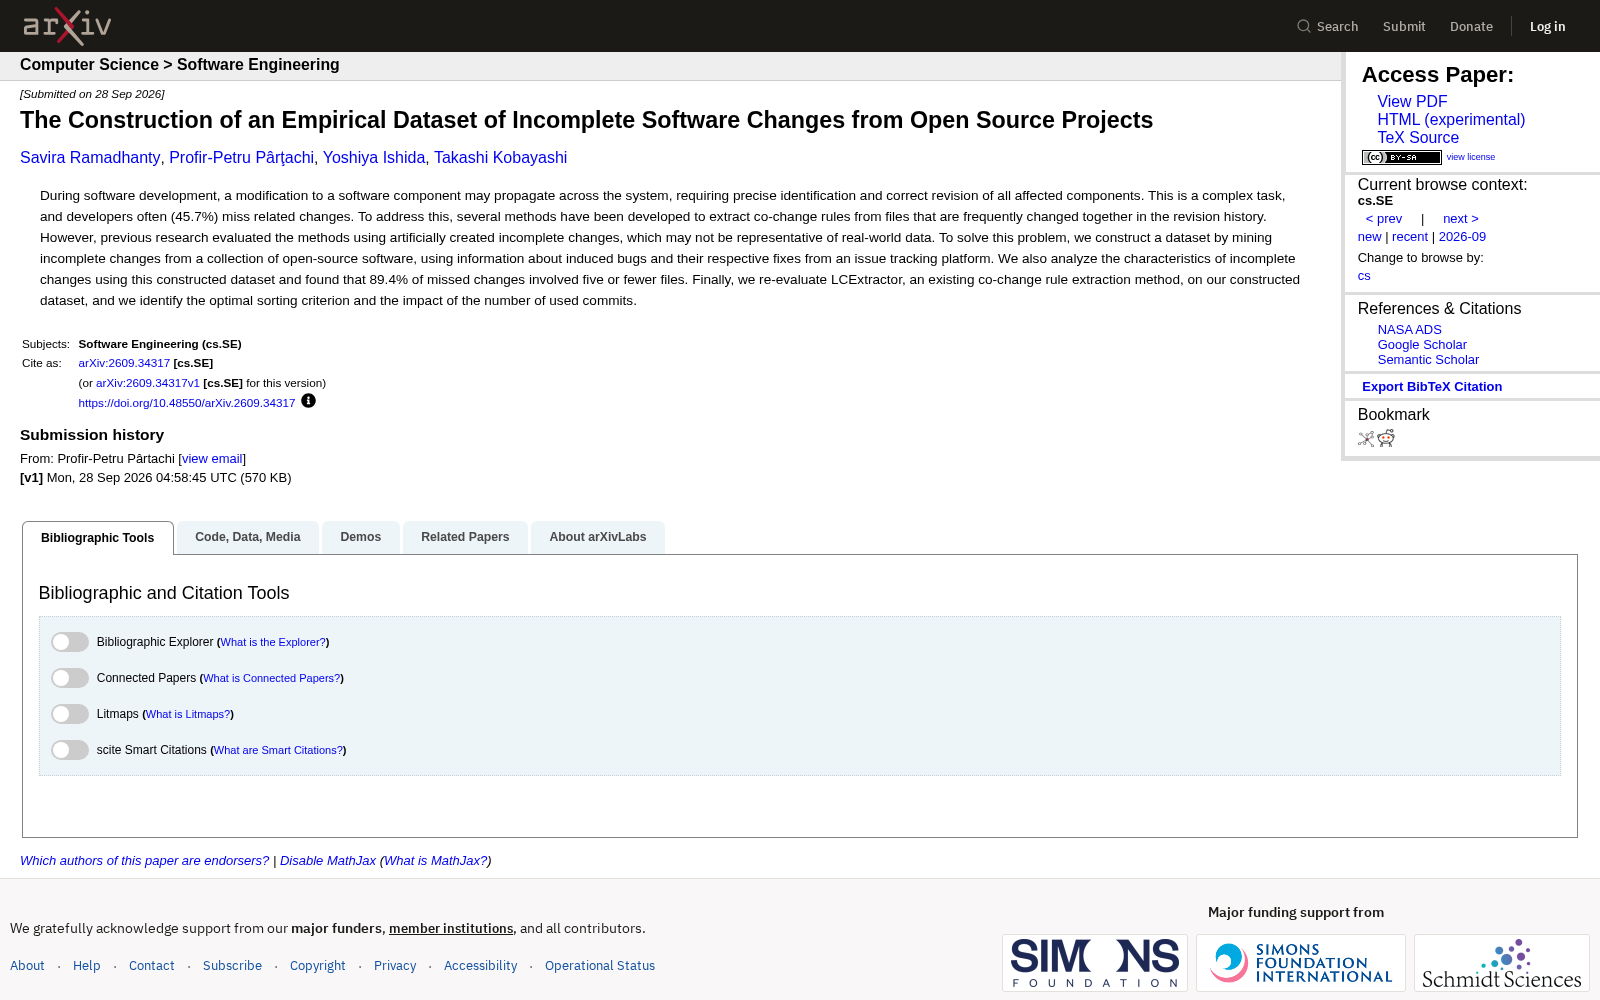
针对这一行业痛点,东京科学大学近期正式发布Empirical Dataset of Incomplete Software Changes(经验性不完整软件变更数据集),该数据集于2026年9月28日首发于学术预印本平台arXiv。据披露,该数据集基于Apache基金会旗下17个主流开源项目的真实运营数据构建,研究团队通过挖掘对应项目Jira问题跟踪系统的标注关联,利用“is broken by”“is caused by”两类关联链接识别缺陷引入提交(BIC)与修复提交(BFC)的配对关系,进一步提取BFC中未被BIC修改的文件作为遗漏变更样本,最终筛选得到3430条有效变更对。为保障数据质量,数据集构建过程中严格过滤了文件存在时间、提交日期等异常记录,同时对单次缺陷诱导、多次缺陷诱导两类场景做了明确标注,可适配不同细分研究方向的需求。
该数据集的落地,为软件工程领域的相关研发与评测提供了真实场景维度的核心数据支撑:一方面可用于评估协同变更规则等各类变更影响分析工具在实际不完整变更场景下的性能表现,弥补了过往依赖人工模拟数据评估的失真缺陷;另一方面也可为代码缺陷修复大模型、智能代码评审工具的训练提供高标注质量的真实样本,有望提升相关智能化工具在生产场景的适配准确率。此外,该数据集还可支撑软件工程领域的缺陷根因分析研究,帮助开发者总结不同类型开源项目的变更遗漏规律,优化代码评审、变更校验的流程规则,降低软件迭代过程中的质量风险。
作为数据要素在软件工程细分领域的典型落地成果,本次发布的数据集填补了全球开源软件变更场景下的真实标注数据空白,对推动DevOps全流程智能化升级、完善开源软件供应链质量管控体系、支撑数字经济底层软件基础设施的稳定性建设均具备重要的参考价值。
查看Empirical Dataset of Incomplete Software Changes
详情页内容: