NVIDIA联合德国AI联盟Soofi发布德语区首个开源合成人物数据集 支撑主权AI训练数据体系建设
随着欧盟《AI法案》全面落地,欧洲主权AI建设对本地化、合规化训练数据的需求持续攀升,而德语区此前长期缺乏符合本土人口结构特征、可免费商用的开源人物画像类数据集,成为制约本土大模型性能、加剧模型地域与群体偏差的核心短板。近日NVIDIA联合德国AI生态联盟Soofi正式发布的Nemotron-Personas-Germany数据集,正是填补这一空白的关键成果。
该数据集采用CC BY 4.0许可,商业与非商业场景均可免费使用,是目前首个完全对齐德国官方人口统计规则的德语合成人物数据集。其合成逻辑完全锚定德国2022年人口普查(Zensus 2022)、德国联邦统计局(Destatis)及各州统计局发布的官方公开数据,由双方联合研发团队共同完成,覆盖姓名、性别、年龄、移民背景、婚姻状况、家庭类型、教育、就业、职业和居住地等全维度人口统计维度,在区域分布、群体代表性上远超此前行业通用的非对齐类合成数据集。
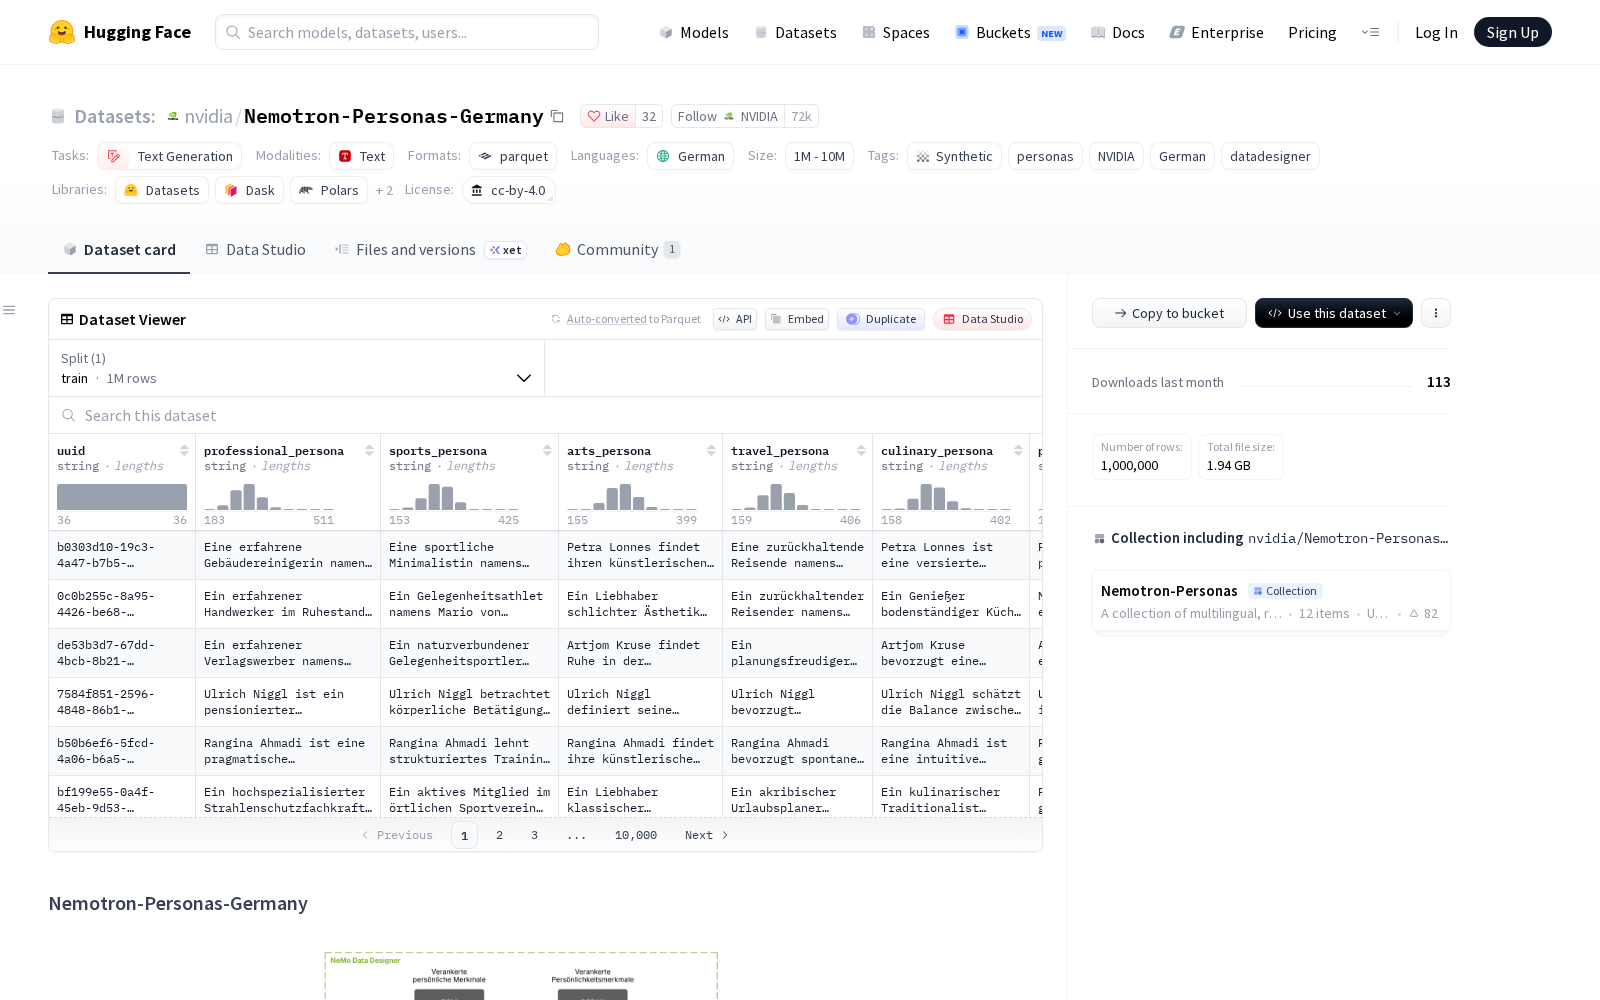
技术层面,数据集依托NVIDIA NeMo Data Designer工具生成,融合专有概率图模型(PGM)、Apache-2.0许可的google/gemma-4-31B-it大模型及内置验证、评估模块完成全链路数据生产与校验。本次发布的1.0版本共包含1,000,000条训练记录,覆盖600万个德语虚拟人物画像,总规模达12.4亿tokens,其中人物属性相关tokens约4.33亿。地域维度覆盖德国全部16个联邦州、400个县及县级市,属性维度包含77.5万个唯一完整姓名、约12000个职业(含20000个性别特定职称)、1243个KldB 2010职业类型,完全匹配德国劳动力市场的统计分类规则。
数据集共设置27个字段,包含唯一标识uuid、6个细分人物画像字段(职业画像、运动偏好、艺术偏好、旅行偏好、美食偏好、综合画像)、6个自然语言属性字段(文化背景、技能专长、技能列表、兴趣爱好、爱好列表、职业目标),以及14个对齐官方统计规则的人口与上下文字段(性别、年龄、婚姻状况、移民背景、家庭类型、住房产权、教育水平、就业状态、职位、所属行业、职业、区县、联邦州、国家)。从应用价值来看,该数据集可广泛应用于多个德语AI研发场景:一是可用于德语大模型的预训练与微调,提升大模型对德语区用户需求的理解精准度,缓解此前普遍存在的地域、职业、移民群体偏差;二是可作为合成数据生产的基础底座,生成符合GDPR合规要求的多轮对话、用户行为等训练数据,避免真实用户数据采集的合规风险;三是可用于AI公平性测试,为招聘、金融、公共服务等领域的AI系统提供标准化的测试样本,排查算法歧视风险,助力欧洲主权AI体系的合规建设。
Nemotron-Personas-Germany的README文件明确标注,数据集所有内容均为人工合成,仅面向18岁及以上用户开放,所有人物特征仅反映人口统计分布,与真实人物重合纯属巧合。数据集暂未包含独立姓名、合成地址、健康与金融属性、人格特质等扩展字段,KldB职业代码也以职业名称、行业分类的形式对外提供,目标用户覆盖主权AI研发、大模型训练、合成数据生成、偏差缓解、模型崩溃预防等领域的开发者与研究人员。
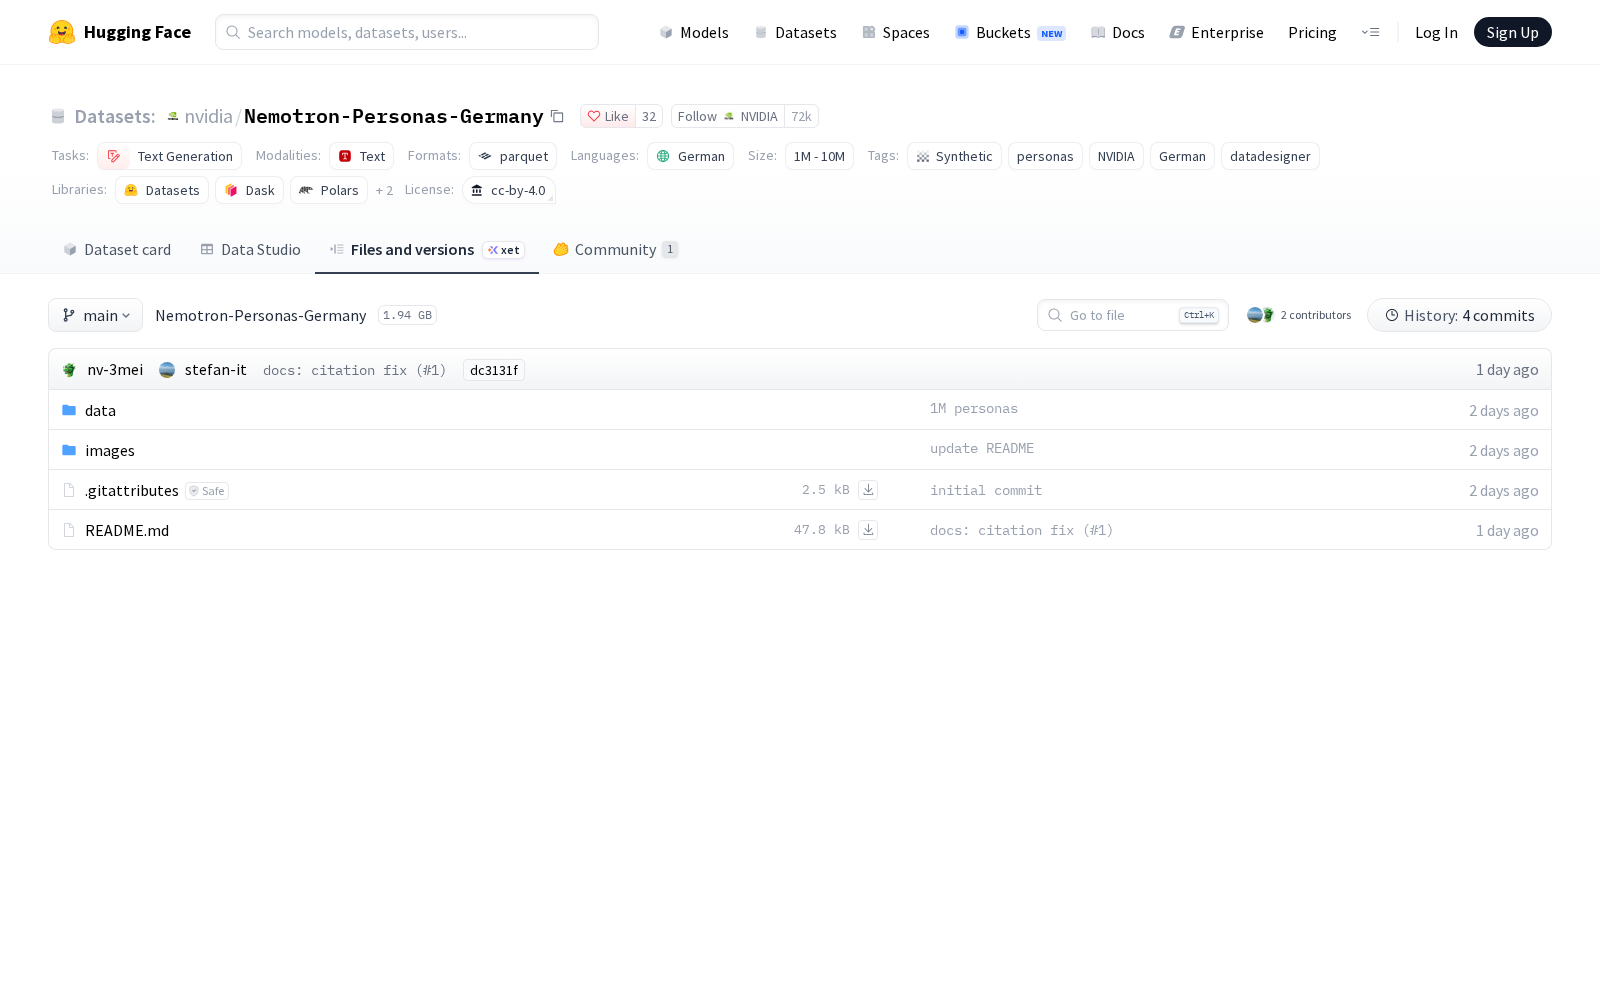
查看Nemotron-Personas-Germany
Dataset card内容:
Files and versions内容: