MBZUAI发布跨体裁现代标准阿拉伯语句子切分基准数据集AraSEG 破解多语言NLP基础任务痛点
随着全球多语言自然语言处理(NLP)技术的商业化落地加速,覆盖小语种、低资源语言的基础标注数据集正在成为数字资源体系的核心供给方向。阿拉伯语作为22个阿拉伯国家的官方语言,全球使用人数超4亿,但受自身标点稀疏、标注不一致、语义歧义性强的语言特性制约,其NLP基础任务长期面临底层标注资源不足的痛点——句子切分作为文本语义理解、翻译、摘要生成等所有上层NLP应用的前置处理环节,此前行业内普遍缺乏适配真实使用场景的标准化基准数据集。
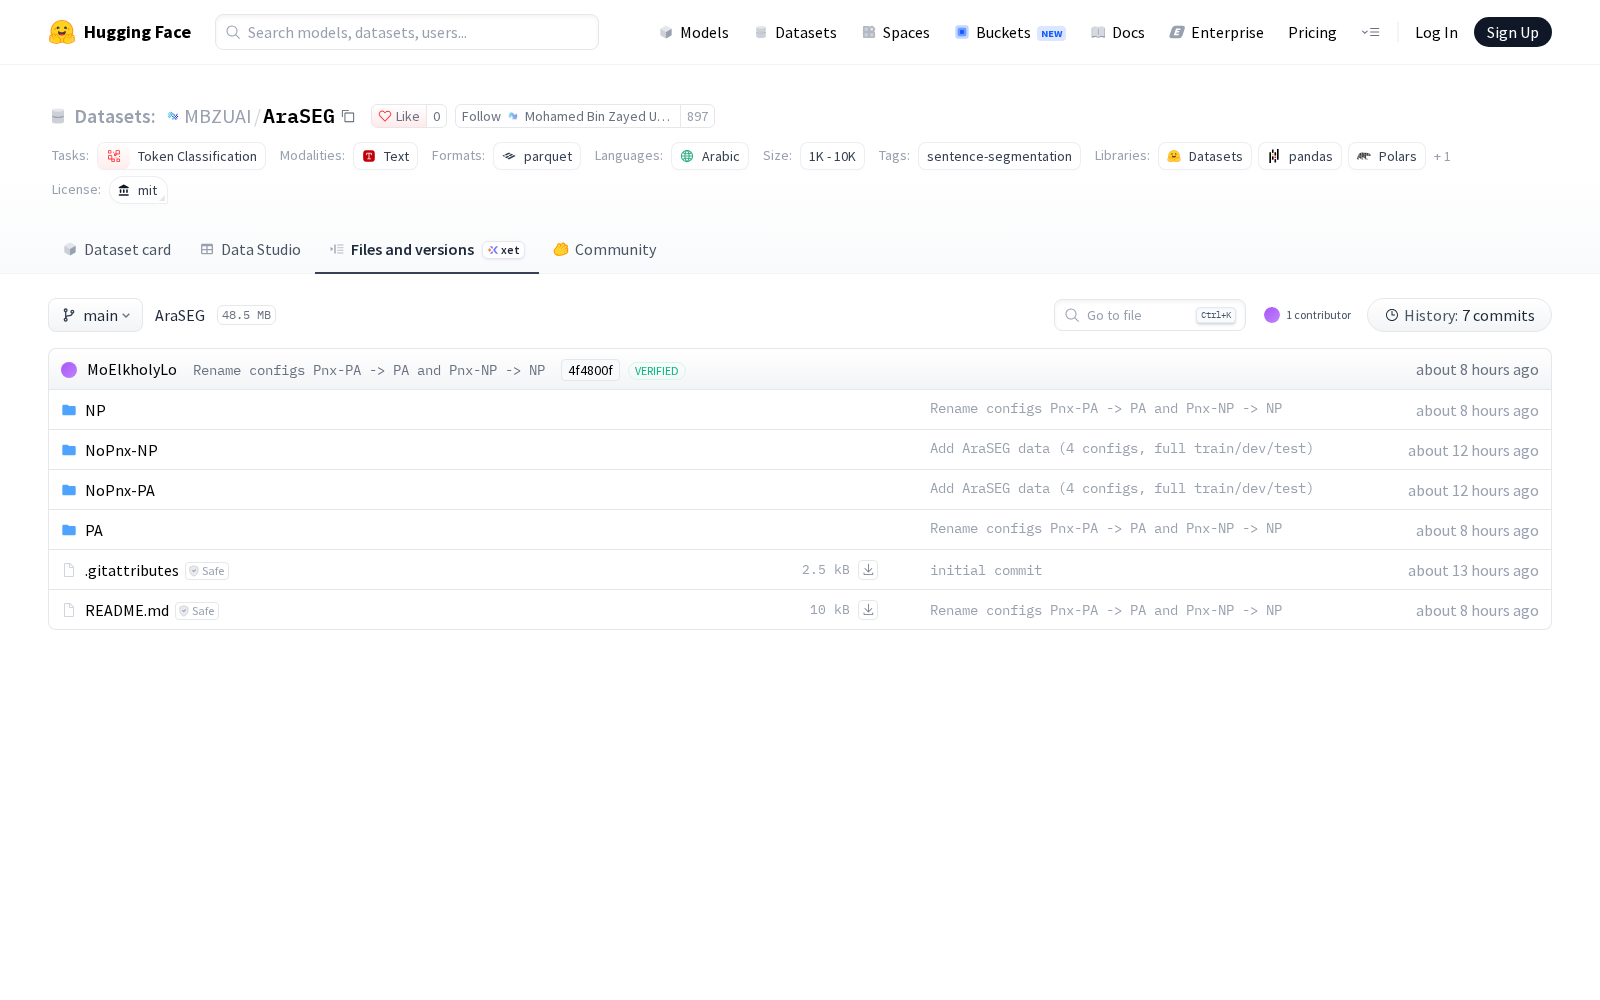
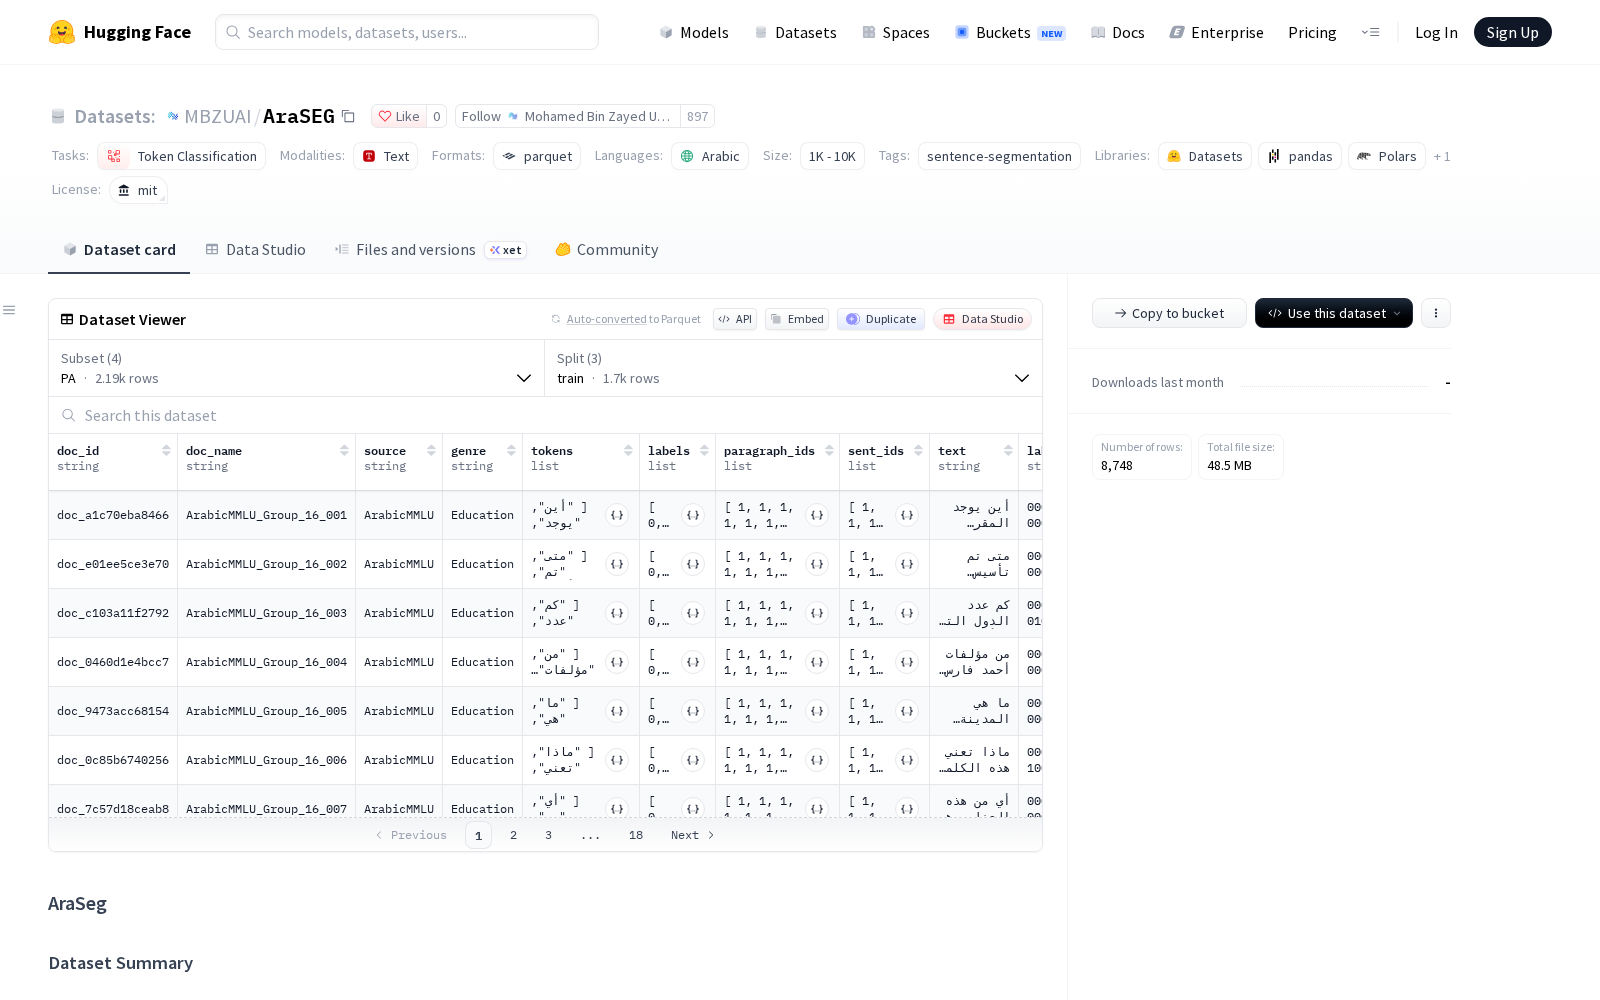
近日,穆罕默德·本·扎耶德人工智能大学(Mohamed Bin Zayed University of Artificial Intelligence,简称MBZUAI)正式发布面向现代标准阿拉伯语(MSA)的手工标注跨体裁句子切分基准数据集AraSEG,该数据集于2026年10月21日首发于HuggingFace平台,采用MIT开源许可证开放授权,可通过datasets.load_dataset直接加载不同配置版本使用,科研人员使用该数据集需引用对应EMNLP 2026 Findings论文。
据公开信息显示,AraSEG数据集总规模包含2187篇文档、48250个段落、121623个句子,约145万token,内容来自30个不同数据源,覆盖儿童、教育、文学、媒体、诗歌、政治、宗教、维基共8大类体裁,可全面适配不同垂直领域的阿拉伯语NLP研发需求。针对阿拉伯语39%的句子边界仅基于词边界、无任何标点标识的特性,AraSEG专门设计覆盖了有标点/无标点、有段落/无段落等多元真实使用场景,其黄金标注资源大部分复用了CAMeL Treebank和BAREC语料库的成熟标注结果,还补充了完整古兰经、新旧约文本进一步拓宽宗教体裁的覆盖度,解决了此前同类数据集体裁覆盖窄、与真实场景适配性差的问题。
为适配不同研发场景需求,AraSEG共提供4种配置变体:默认配置PA保留段落边界和标点;NP配置保留标点但移除段落边界;NoPnx-PA配置保留段落边界但移除所有标点、符号字符及特殊来源的边界标记;NoPnx-NP配置同时移除段落边界和标点。数据集采用8:1:1的比例在文档级别完成训练集、验证集、测试集划分,避免数据泄露问题,评测指标采用边界精确率、边界召回率、边界F1值的文档宏平均计算方式,避免长文档权重过高导致的评测结果失真。
从应用价值来看,AraSEG作为标准化的阿拉伯语句子切分基准数据集,可支撑多类垂直场景的NLP研发需求:包括阿拉伯语智能客服的语义意图识别前置处理、宗教典籍的数字化语义标注与检索、教育内容的自动分句与知识点拆解、媒体内容的智能审核与摘要生成、诗歌文学的语义分析与创作辅助、跨语言翻译的源语言预处理等。该数据集的发布不仅填补了现代标准阿拉伯语句子切分领域的标注资源空白,也为全球低资源语言的基准数据集建设提供了可参考的规范路径,对推动多语言数字资源互联互通、完善多语言数据要素市场的基础资源供给具有积极意义。
Dataset card内容:
Files and versions内容: