里昂国立应用科学学院牵头发布CountVideoBench数据集 破解视频语言模型计数能力评测痛点
随着多模态大模型技术的快速迭代,视频语言模型(VideoLLM)已逐步落地到视频问答、智能安防、内容审核、工业视觉等多个场景,但针对其计数能力的标准化评测始终是行业公认的技术短板:现有主流VideoQA计数基准普遍存在样本分布高度偏斜的问题,低基数样本占比过高、高基数样本稀缺,既无法准确识别模型在不同计数量级下的预测偏差,也难以支撑零样本场景下的能力校验,成为制约视频大模型落地精度的重要瓶颈。
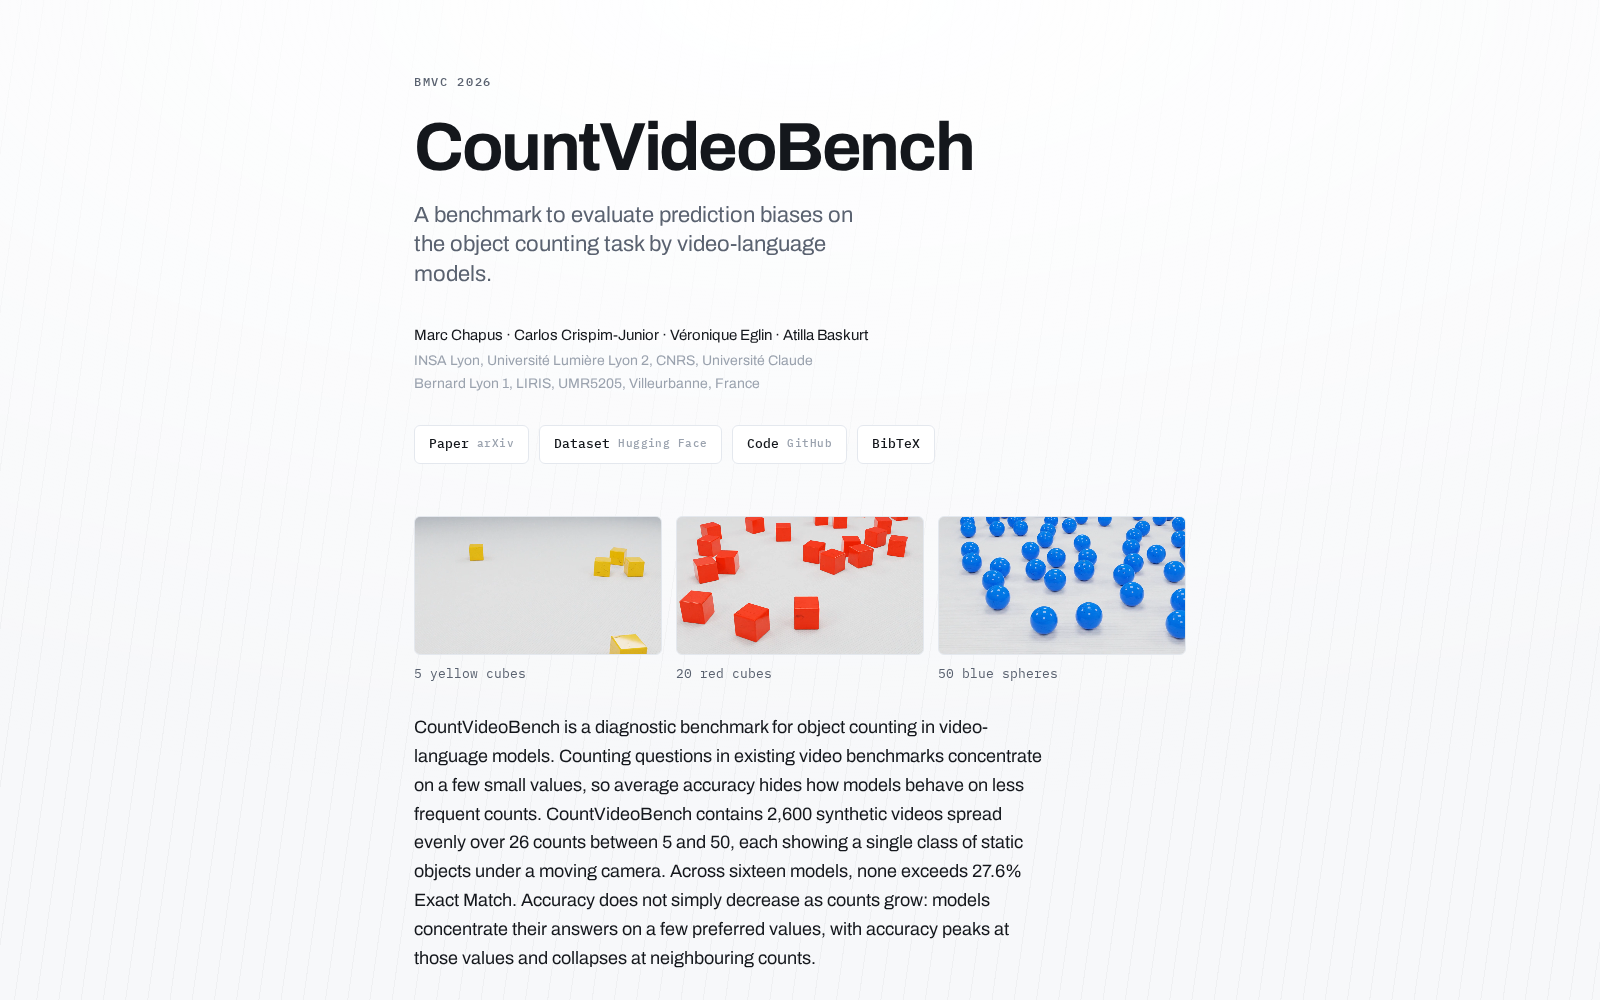
本次由里昂国立应用科学学院牵头,联合卢米埃里昂第二大学、法国国家科学研究中心、克洛德·贝尔纳里昂第一大学等机构在LIRIS实验室(法国国家级计算机视觉与智能系统核心科研平台)构建的CountVideoBench,正是专门针对上述行业痛点设计的视频目标计数诊断基准,核心目标是精准评估视频语言模型在不同基数下的计数能力与预测偏差。据公开资料显示,该数据集共包含2600段合成视频,均匀覆盖[5,50]区间内的26个计数基数,每个基数对应100段独立视频;所有视频均为5秒时长、30fps帧率、1920×1080分辨率,画面仅包含单一类别的静态几何物体,并配合受控的相机运动参数,最大程度隔离了物体识别偏差、动态物体运动干扰等无关变量的影响。为进一步提升评测的科学性,所有视频均通过Blender工具程序化生成,采用锚点-邻域结构围绕5、10、20、30、40、50等关键计数节点采样,确保相邻计数区间的样本可直接进行横向比较,精准定位模型的能力阈值。
作为行业首个覆盖全基数区间的视频计数评测基准,CountVideoBench主要面向视频语言模型零样本计数评测场景,可有效解决现有评测基准的分布缺陷。从产业应用来看,该数据集可用于多模态大模型研发过程中的计数能力校验,帮助研发团队定位模型在高基数计数场景下的性能短板;也可为下游落地场景提供标准化测试工具,比如智慧安防领域的人流、车流计数算法评测,仓储物流场景的货物清点模型验证,泛娱乐内容平台的特定元素统计功能测试等,为视频大模型从实验室走向产业落地提供更可靠的能力校验依据,也为全球数据要素市场的评测类数据集供给补充了重要的细分品类。
详情页内容: