伯克利发布FrontierCS 2基准数据集 为大模型科研智能体代码贡献能力建立行业评测标尺
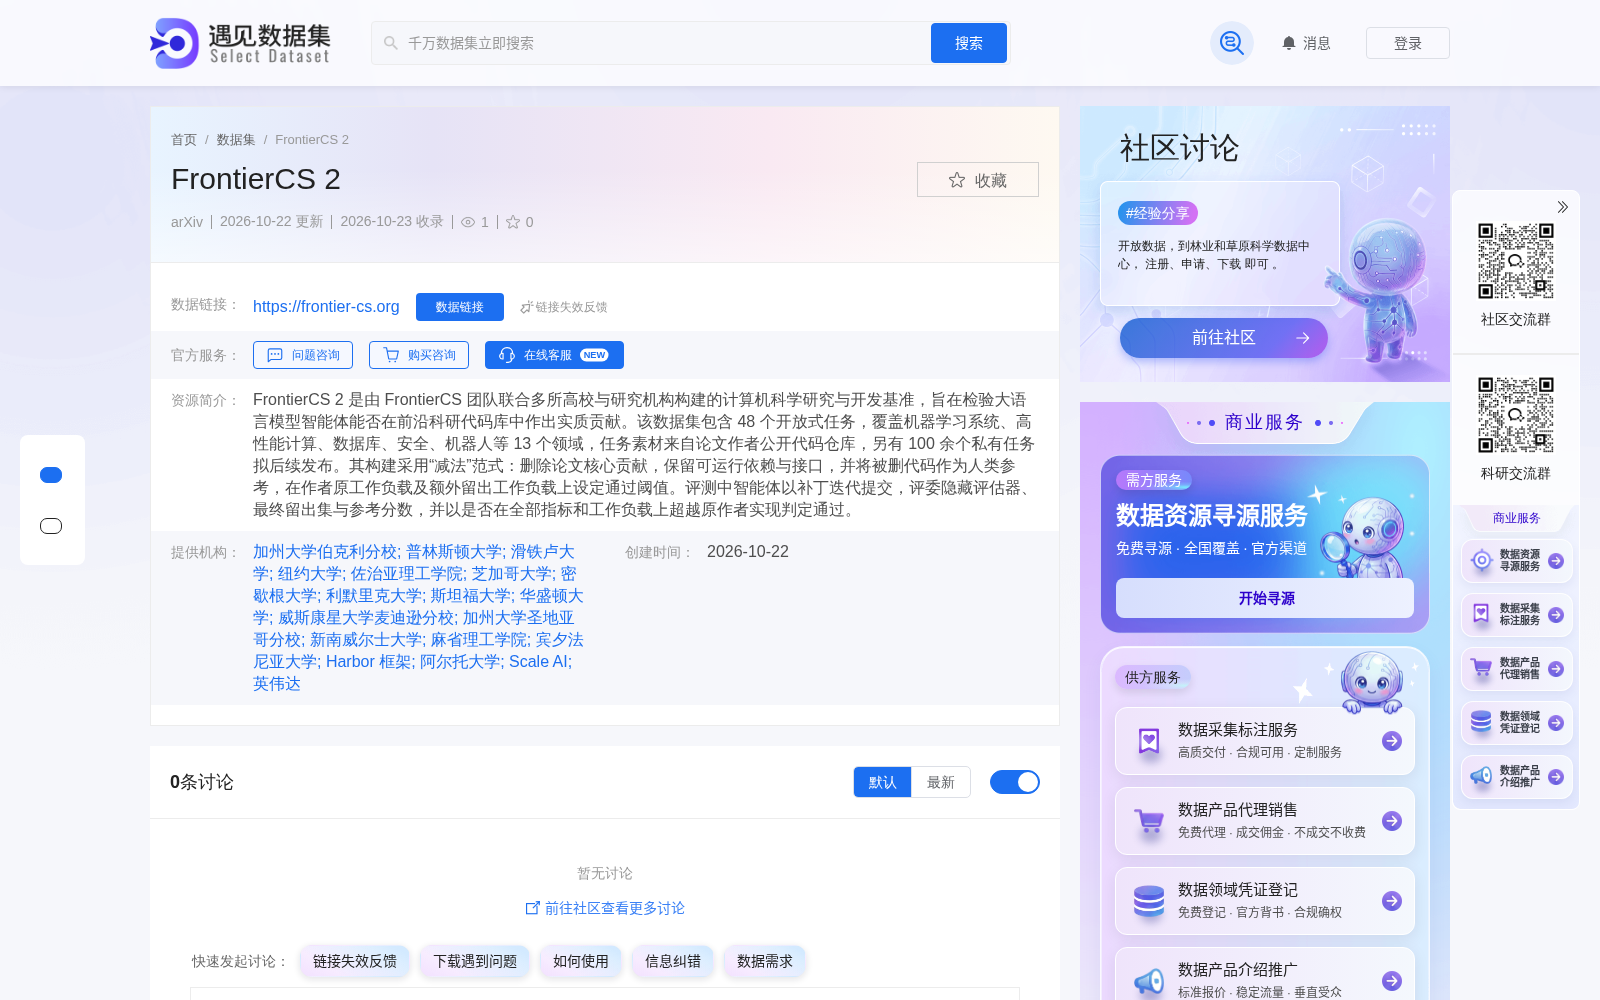
随着大语言模型技术在代码生成领域的快速落地,面向真实科研场景的智能体代码贡献能力评测,长期缺乏贴近前沿生产环境的统一基准,成为制约科研智能体迭代与商业化落地的核心瓶颈之一。2026年10月22日,加州大学伯克利分校FrontierCS团队联合多所高校与研究机构,在预印本平台arXiv首发全新计算机科学研究与开发基准数据集FrontierCS 2,专门用于检验大语言模型智能体能否在前沿科研代码库中作出实质性贡献。
本次公开的FrontierCS 2首批包含48个开放式评测任务,覆盖机器学习系统、高性能计算、数据库、网络安全、机器人等13个计算机核心前沿领域,所有任务素材均来自对应领域顶会论文作者公开的代码仓库,另有100余个私有任务拟于后续逐步开放,进一步扩大评测覆盖的场景范围。和传统代码评测数据集大多采用命题式任务设计不同,FrontierCS 2创新性采用「减法」构建范式:在保留原项目可运行依赖与接口的前提下,删除对应论文的核心贡献代码,将被删除的原作者实现作为人类参考基准,同时在作者原工作负载及额外留出的独立工作负载上设定严格的通过阈值,最大程度还原真实科研项目的开发环境与能力要求。
该数据集的评测流程完全对齐开源社区代码贡献模式:参与评测的智能体以补丁迭代方式提交代码,评测过程采用盲评机制,评估器、最终留出测试集与参考分数全程对参评方隐藏,只有当智能体提交的代码在全部评测指标与所有工作负载上的表现均超越原作者实现时,才判定为任务通过,评测标准远高于通用代码生成能力测试。
作为当前为数不多面向前沿科研场景的代码类基准数据集,FrontierCS 2可广泛应用于大语言模型科研智能体能力迭代、科研代码库自动补丁贡献工具评测、AI辅助科研系统性能验证等多个场景,其推出不仅填补了前沿科研代码贡献能力评测的基准空白,也为整个科研智能体赛道建立了统一的能力标尺,将进一步推动大模型从通用代码生成向专业化科研生产工具的落地进程,助力计算机领域科研效率的提升。
详情页内容: