Hugging Face发布funes-swe-chat-zh-e5数据集 面向中文场景赋能智能体记忆召回与会话轨迹编码
当前,大模型智能体(Agent)已成为AI产业落地的核心方向之一,而记忆模块的召回效率、长上下文适配能力,是决定智能体交互体验与任务完成率的核心瓶颈,尤其是面向中文场景的高质量编码会话数据缺口,长期制约着国内代码类智能体的迭代效率。本次Hugging Face上线的funes-swe-chat-zh-e5,正是funes memory系列面向智能体记忆与召回场景推出的垂直数据集,底层基于SALT-NLP/SWE-chat v2构建,针对中文编码会话做了专门的筛选适配。
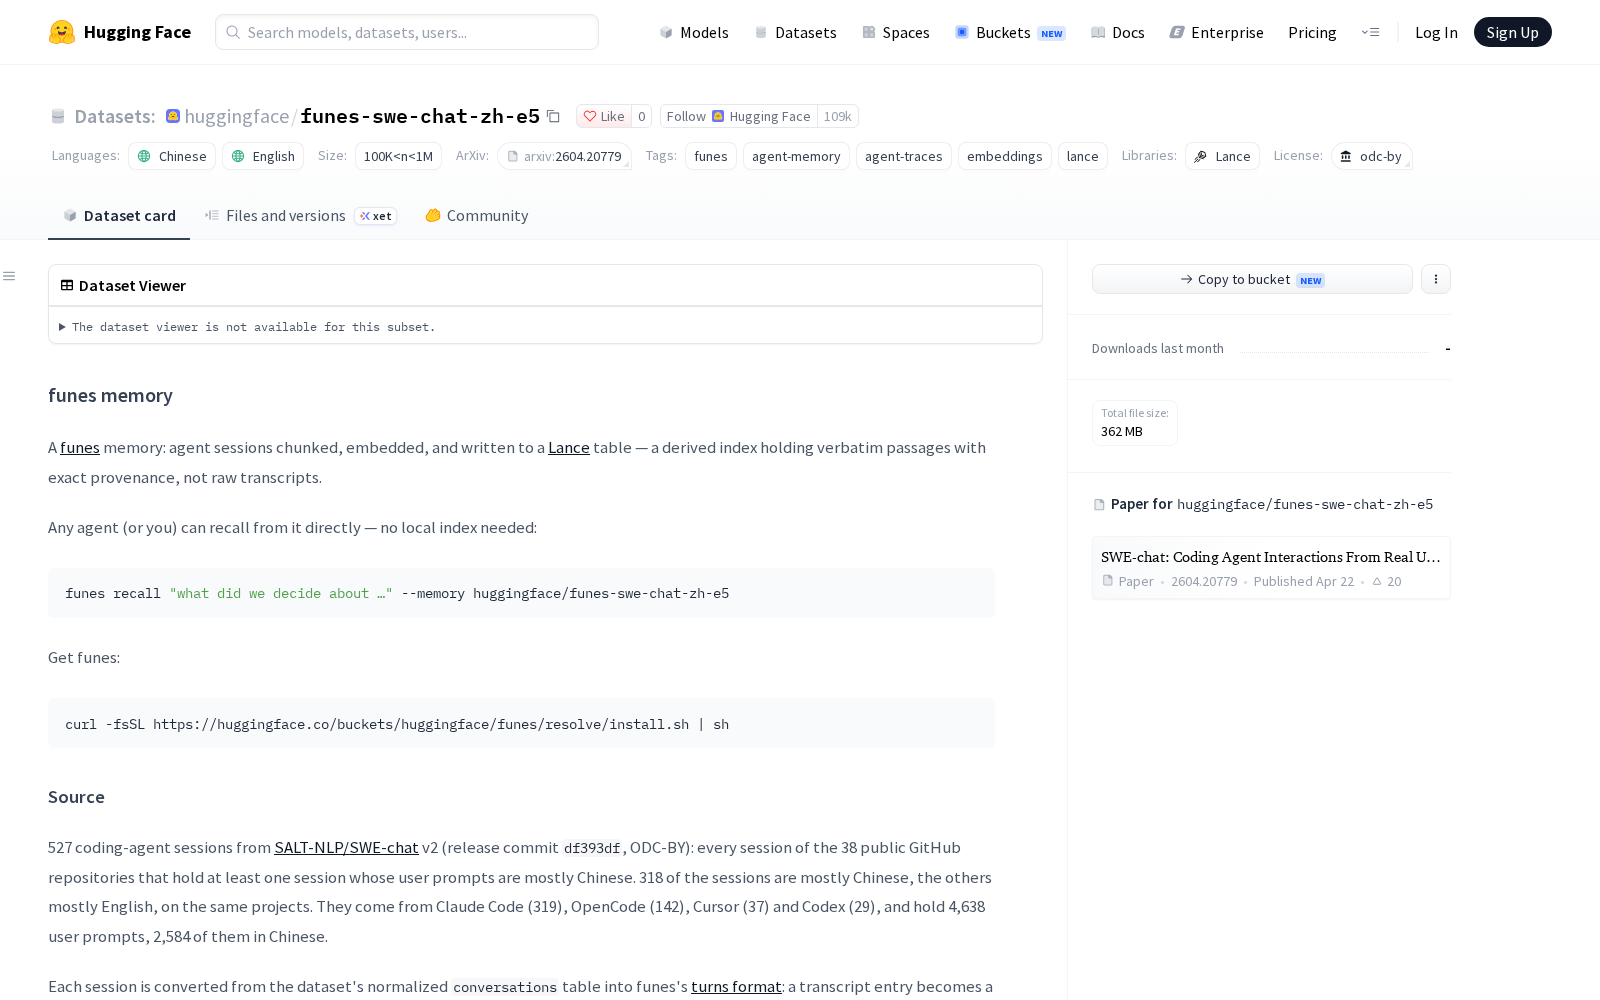
区别于传统会话数据集存储原始转写文本的逻辑,funes-swe-chat-zh-e5创新性地将编码智能体会话分块、嵌入后写入Lance表,形成保留逐字片段及其精确来源的派生索引,智能体或开发者可直接从中召回所需信息,无需在本地完成数据清洗、嵌入、索引构建等前置工作,大幅缩短开发周期。该数据集数据源为SWE-chat v2发布提交df393df(ODC-BY),包含527个编码智能体会话,覆盖38个公共GitHub仓库,所有仓库均至少有一个会话的用户提示以中文为主,其中318个会话整体以中文为主要语言,其余为英文会话,覆盖同一批项目范畴。
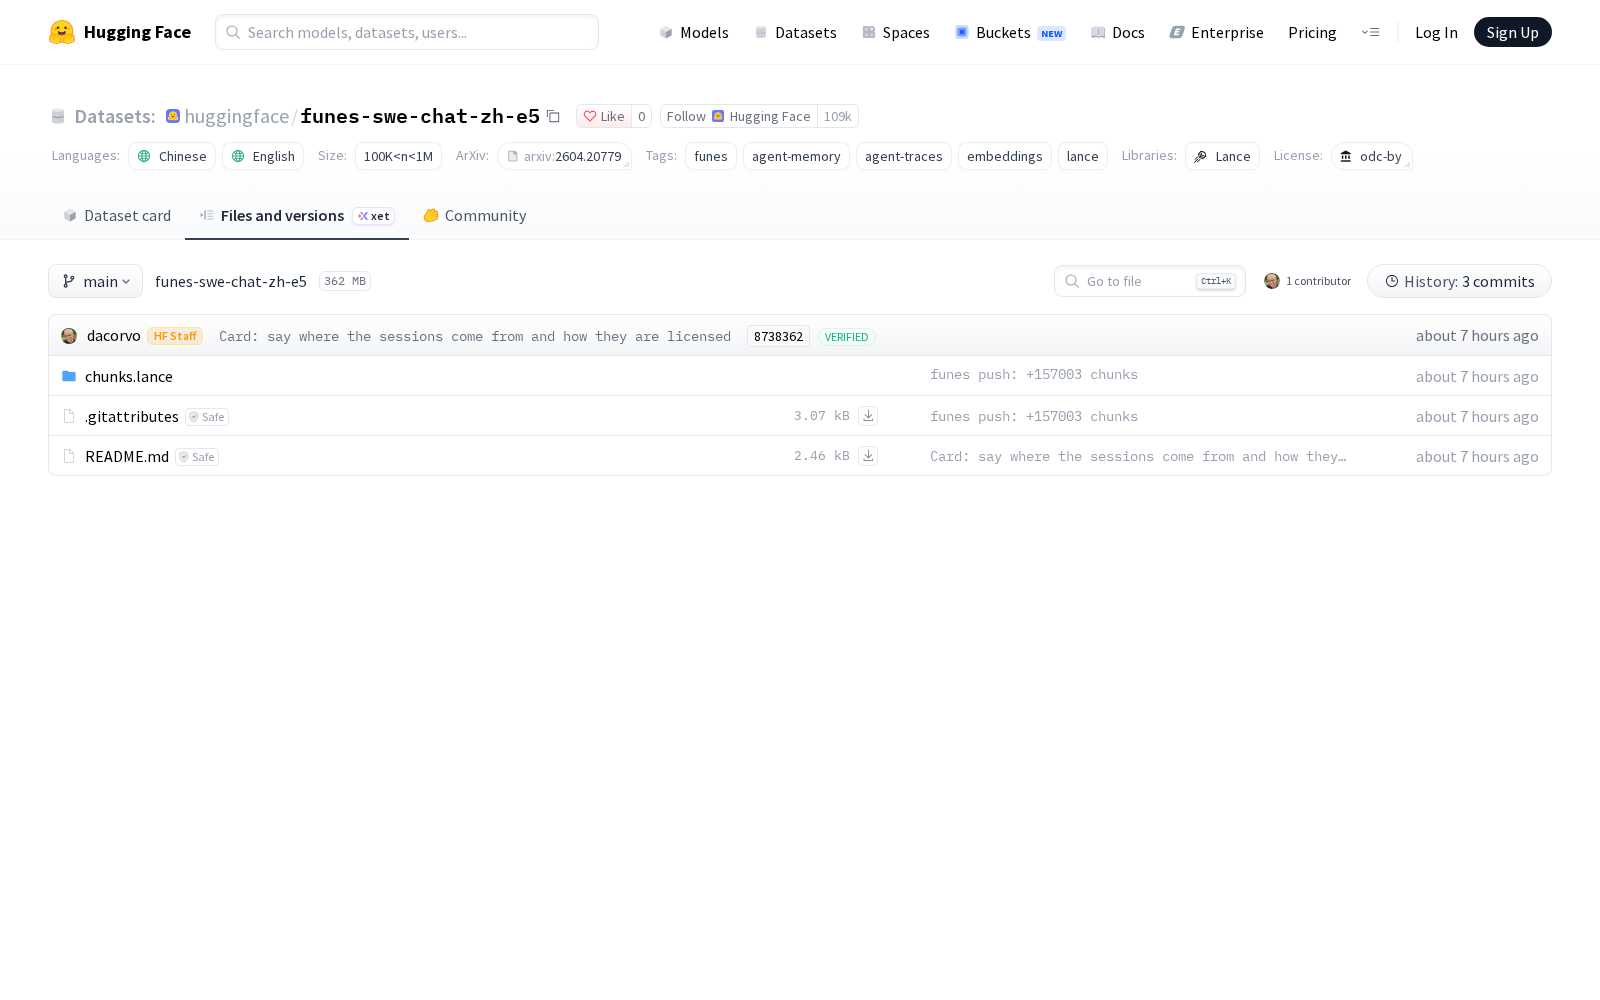
从数据构成来看,会话来源覆盖Claude Code(319个)、OpenCode(142个)、Cursor(37个)和Codex(29个)四大类编码智能体,共包含4638条用户提示,其中2584条为中文提示。数据集处理阶段,每个会话从源数据集的规范化conversations表转换为funes turns格式:一条transcript条目成为一个turn,其行成为该turn的blocks,涵盖提示、回复、思考、工具调用和工具结果全链路内容,仅排除元数据行、以及1个名称为unknown且跨仓库id冲突的会话;OpenCode会话与源数据保持一致,带有工具调用标识但不包含对应结果。数据采用intfloat/multilingual-e5-small进行嵌入,配套icu文本索引,由funes 1.9.0版本生成,发布前已完成敏感信息清洗,157022个数据块中共有19个含秘密信息的块被移除。当前数据集统计共有157003个chunks,更新于2026-10-22,由funes push发布并保持后续迭代更新。
从行业应用来看,该数据集可广泛适配多类智能体开发场景:在AI编码助手场景中,可用于优化长会话下的历史需求召回能力,避免智能体遗忘前期开发约定、反复确认重复信息;在智能体行为研究领域,可作为样本支撑编码类Agent的会话轨迹分析,优化工具调用、思考链生成逻辑;针对中英双语混合的开发场景,数据集的双语属性也能适配出海开发工具、多语言协作开发平台的智能体训练需求。
作为当前少有的适配中文场景的智能体记忆专项数据集,funes-swe-chat-zh-e5的发布填补了细分赛道的供给空白,其采用的ODC-BY许可证与源数据保持一致,开发者仅需引用SWE-chat相关论文《SWE-chat: Real-World AI Coding Sessions in the Wild》(Baumann et al., COLM 2026, arXiv:2604.20779)即可合规使用,进一步降低了中小团队的开发成本,对于推动中文Agent生态的繁荣、完善AI训练数据要素供给体系具有积极意义。值得注意的是,SWE-chat仅收录允许再分发的仓库,会话涉及的代码仍需遵循各自对应许可证。该数据集语言为中文和英文,标签包括funes、agent-memory、agent-traces、embeddings、lance,规模类别为100K
Dataset card内容:
Files and versions内容: