LAION发布多语言情绪语音评测数据集 覆盖表达性TTS、情绪掩蔽评估两大核心场景
随着生成式AI技术的快速落地,虚拟人交互、有声内容生产、智能客服、影视AI配音等场景对语音的表达性、真实感要求持续提升,但行业长期缺乏覆盖复杂情绪场景、标注规范、可跨版本对比的标准化评测数据集,成为制约表达性语音合成技术迭代的核心瓶颈之一。近日,全球知名开源AI数据集研发机构LAION eV正式上线的全新语音数据集,恰好填补了这一领域的空白。
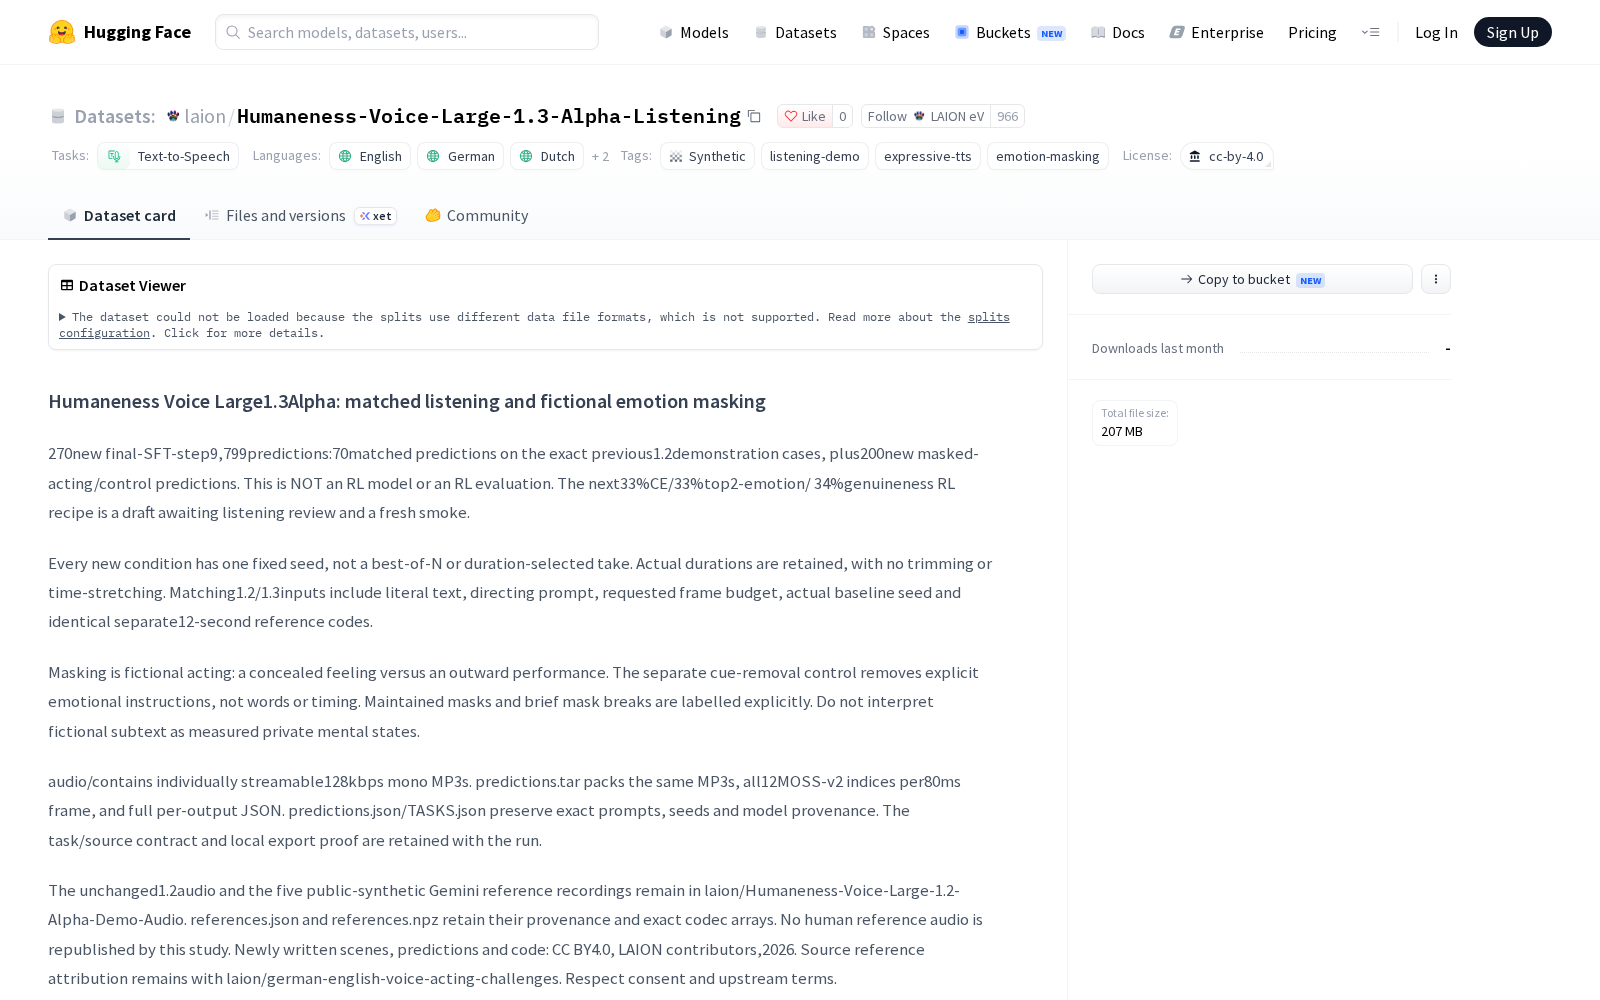
LAION eV是全球最具影响力的开源AI数据机构之一,其此前发布的LAION系列图文数据集是Stable Diffusion等主流生成式AI模型的核心训练数据源,在多模态、语音等AI基础数据领域的研发成果被全球研发团队广泛采用。本次发布的Humaneness-Voice-Large-1.3-Alpha-Listening是其在语音领域的最新迭代成果,核心定位为文本转语音(TTS)方向的聆听演示与评测数据集,核心主题为「匹配聆听与虚构情绪掩蔽」,即针对人类真实表达中「内在感受与外在表演情绪存在差异」的复杂场景设计,填补了此前多数语音数据集仅覆盖单一直白情绪标注的空白。
本次发布的数据集采用CC BY 4.0开源协议,支持商业使用,覆盖英语、德语、荷兰语、法语、西班牙语五种主流欧洲语言,全量包含9799条预测数据,其中新增270条final-SFT-step预测,涵盖70条与此前1.2版本演示案例完全匹配的预测、200条新增的masked-acting/control预测,可直接实现与1.2版本数据集的横向对比,方便研发团队跟踪技术迭代效果。
官方文档明确说明,该数据集并非RL(强化学习)模型或RL评估数据集,后续33% CE/33% top2-emotion/34% genuineness的RL评测配方仍处于草稿阶段,待后续聆听评审完成后更新。为保证评测的公正性,数据集中每个生成条件均使用固定随机种子,未采用best-of-N筛选或按时长挑选的处理逻辑,所有音频均保留实际时长,未进行裁剪或时间拉伸处理;与1.2版本完全对齐的输入参数(包括字面文本、导演提示、请求的帧预算、实际基线种子、相同的独立12秒参考编码)也进一步提升了跨版本评测的可靠性。针对核心的「情绪掩蔽」标注,官方明确其定义为虚构表演场景下的内在感受与外在表演的情绪对比,额外设置了单独的cue-removal控制组移除显式情绪指令,仅保留文本与时间参数,同时对维持的掩蔽、短暂掩蔽中断场景进行了显式标注,并特别提示不应将数据集中的虚构潜台词解释为测量到的真实私人心理状态,避免数据误用。
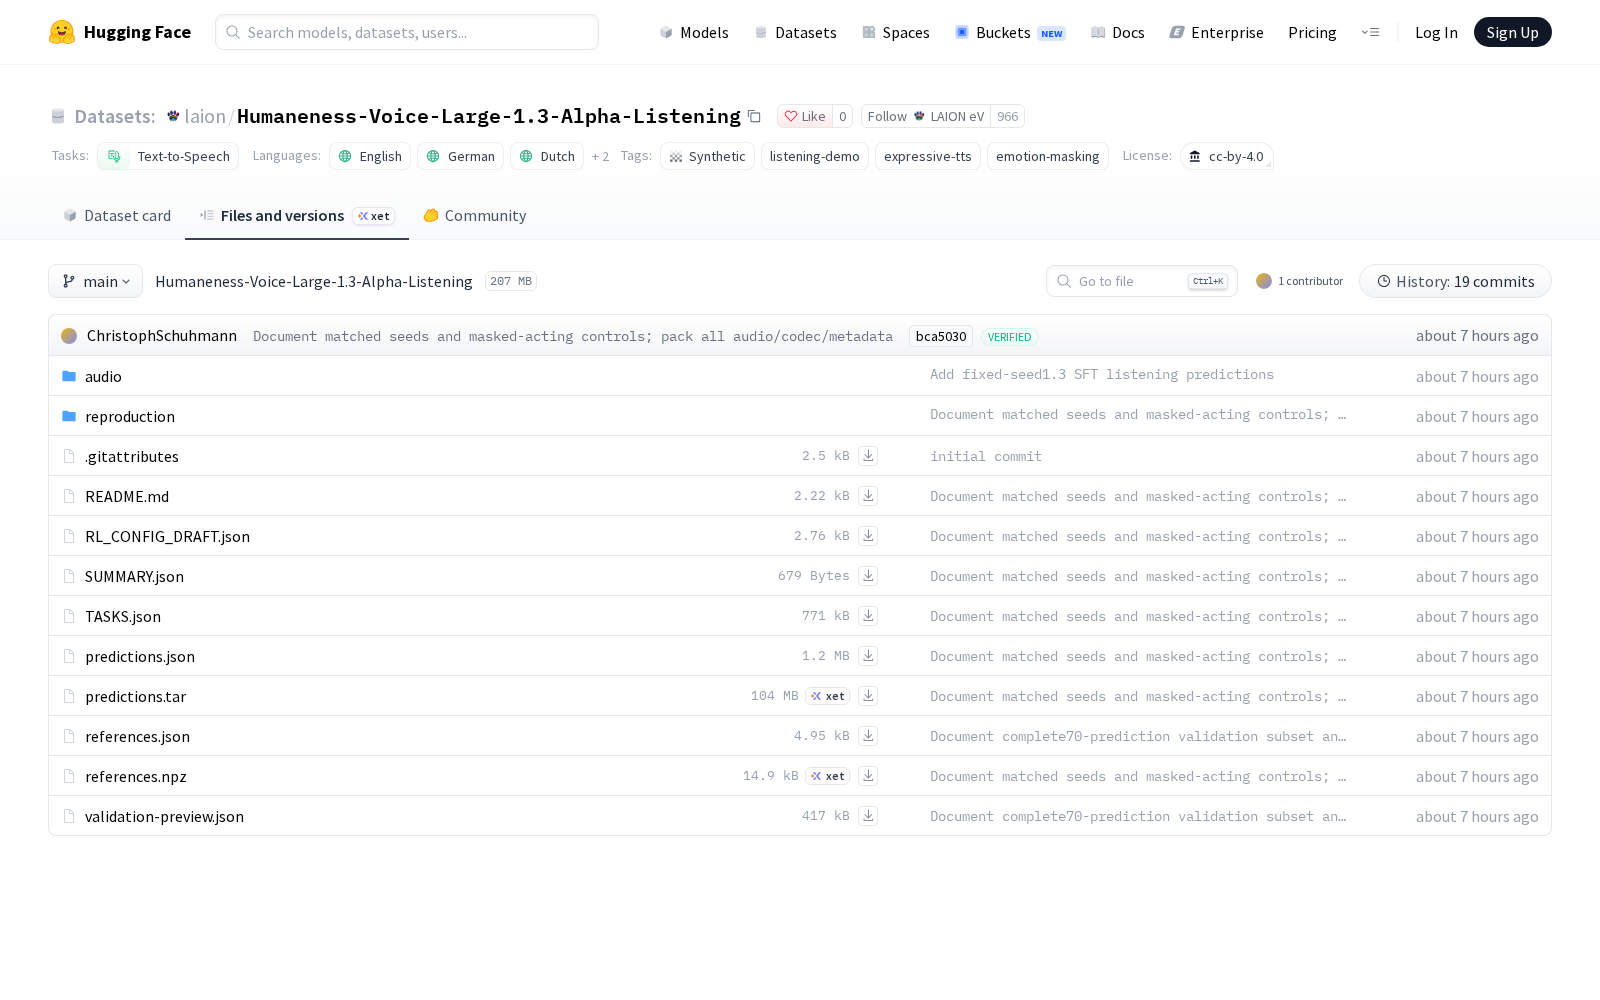
在文件结构方面,数据集的audio/文件夹包含可单独流式播放的128 kbps单声道MP3文件;predictions.tar压缩包则打包了相同MP3文件、每80ms帧对应的全部12个MOSS-v2索引以及完整的逐输出JSON文件;predictions.json与TASKS.json文件保留了所有提示词、随机种子与模型来源信息,任务/来源合约和本地导出证明也随数据集同步发布,方便研发团队溯源。此外,未修改的1.2版本音频与五个公共合成Gemini参考录音仍保留在laion/Humaneness-Voice-Large-1.2-Alpha-Demo-Audio仓库,本次未重新发布人类参考音频;本次新增的场景、预测数据与代码采用CC BY 4.0协议,归属LAION贡献者所有,源参考归属保留在laion/german-english-voice-acting-challenges仓库,使用者需遵守对应上游条款。官方同时特别强调,仅凭本次发布的聆听页面无法直接确立CE、情绪、真实性或说话人相似度的技术改进,当前汇总值仅覆盖时长与运行时维度。
从应用价值来看,该数据集可广泛应用于多个AI语音核心场景:一是表达性TTS研发评测,可用于测试虚拟人语音、有声书配音、智能客服、影视AI配音等场景下的TTS模型情绪表达准确度、表演场景贴合度,推动生成语音从「可听懂」向「有感情、会表演」升级;二是情绪掩蔽听感评估,可用于测试语音情绪识别模型的鲁棒性,模拟真实场景中人类「言不由衷」的表达场景,提升情绪识别模型在客服、心理咨询、公共安全等落地场景的实用性;三是合成语音真实性校验,可用于AI生成语音检测、深度伪造语音识别模型的训练与评测,提升语音身份认证、内容审核等系统的可靠性。作为当前少有的覆盖复杂情绪表演场景的开源语音评测数据集,本次发布的数据集将进一步降低全球AI语音研发团队的测试数据门槛,推动多语种表达性语音合成技术的标准化迭代,为语音交互技术的场景落地提供核心数据支撑。
LAION eV本次发布的数据集Humaneness-Voice-Large-1.3-Alpha-Listening,Humaneness Voice Large 1.3 Alpha 是一个面向文本到语音(text-to-speech)的聆听演示/评测数据集,主题为匹配聆听与虚构情绪掩蔽(matched listening and fictional emotion masking)。其许可证为 CC BY 4.0,语言覆盖英语、德语、荷兰语、法语和西班牙语,任务类别为 text-to-speech,标签包括 synthetic、listening-demo、expressive-tts、emotion-masking。README 说明该页面提供 final-SFT-step 的新预测:270 个新的 final-SFT-step 预测,并出现 9,799 predictions 这一规模数字;文本还说明有 70 条与先前 1.2 演示案例完全匹配的预测,以及 200 条新的 masked-acting/control 预测。该数据集不是 RL 模型或 RL 评估;下一步 33% CE/33% top2-emotion/34% genuineness 的 RL 配方尚为草稿,等待聆听评审和新的 smoke。每个新条件使用一个固定随机种子,不是 best-of-N 或按持续时间挑选的版本;保留实际时长,不裁剪或时间拉伸。匹配 1.2/1.3 的输入包括字面文本、导演提示、请求的帧预算、实际基线种子以及相同的独立 12 秒参考编码。掩蔽被定义为虚构表演:隐藏的感受与外在表演之间的对比。单独的 cue-removal 控制移除显式情绪指令,而非词语或时间;维持的掩蔽和短暂掩蔽中断被显式标注。不应将虚构潜台词解释为测量到的私人心理状态。数据文件方面,audio/ 包含可单独流式播放的 128 kbps 单声道 MP3;predictions.tar 打包相同 MP3、每 80 ms 帧的全部 12 个 MOSS-v2 索引以及完整的逐输出 JSON;predictions.json/TASKS.json 保留精确提示、种子和模型来源;任务/来源合约和本地导出证明随运行保留。未更改的 1.2 音频和五个公共合成 Gemini 参考录音保留在 laion/Humaneness-Voice-Large-1.2-Alpha-Demo-Audio;references.json 与 references.npz 保留其来源和精确编解码数组;本研究不重新发布人类参考音频。新撰写的场景、预测和代码采用 CC BY 4.0,LAION contributors,2026;源参考归属保留在 laion/german-english-voice-acting-challenges,使用时需尊重同意和上游条款。README 强调,仅凭该聆听页面不能确立 CE、情绪、真实性或说话人相似度的改进;当前汇总值只覆盖时长和运行时。数据集适合用于表达性 TTS、情绪掩蔽/对照听感评估以及相关合成语音预测的检查。
查看Humaneness-Voice-Large-1.3-Alpha-Listening
Dataset card内容:
Files and versions内容: