TII发布2亿级图文元数据集OpenLVD-200m 上线HuggingFace覆盖视觉大模型蒸馏、数据策展场景
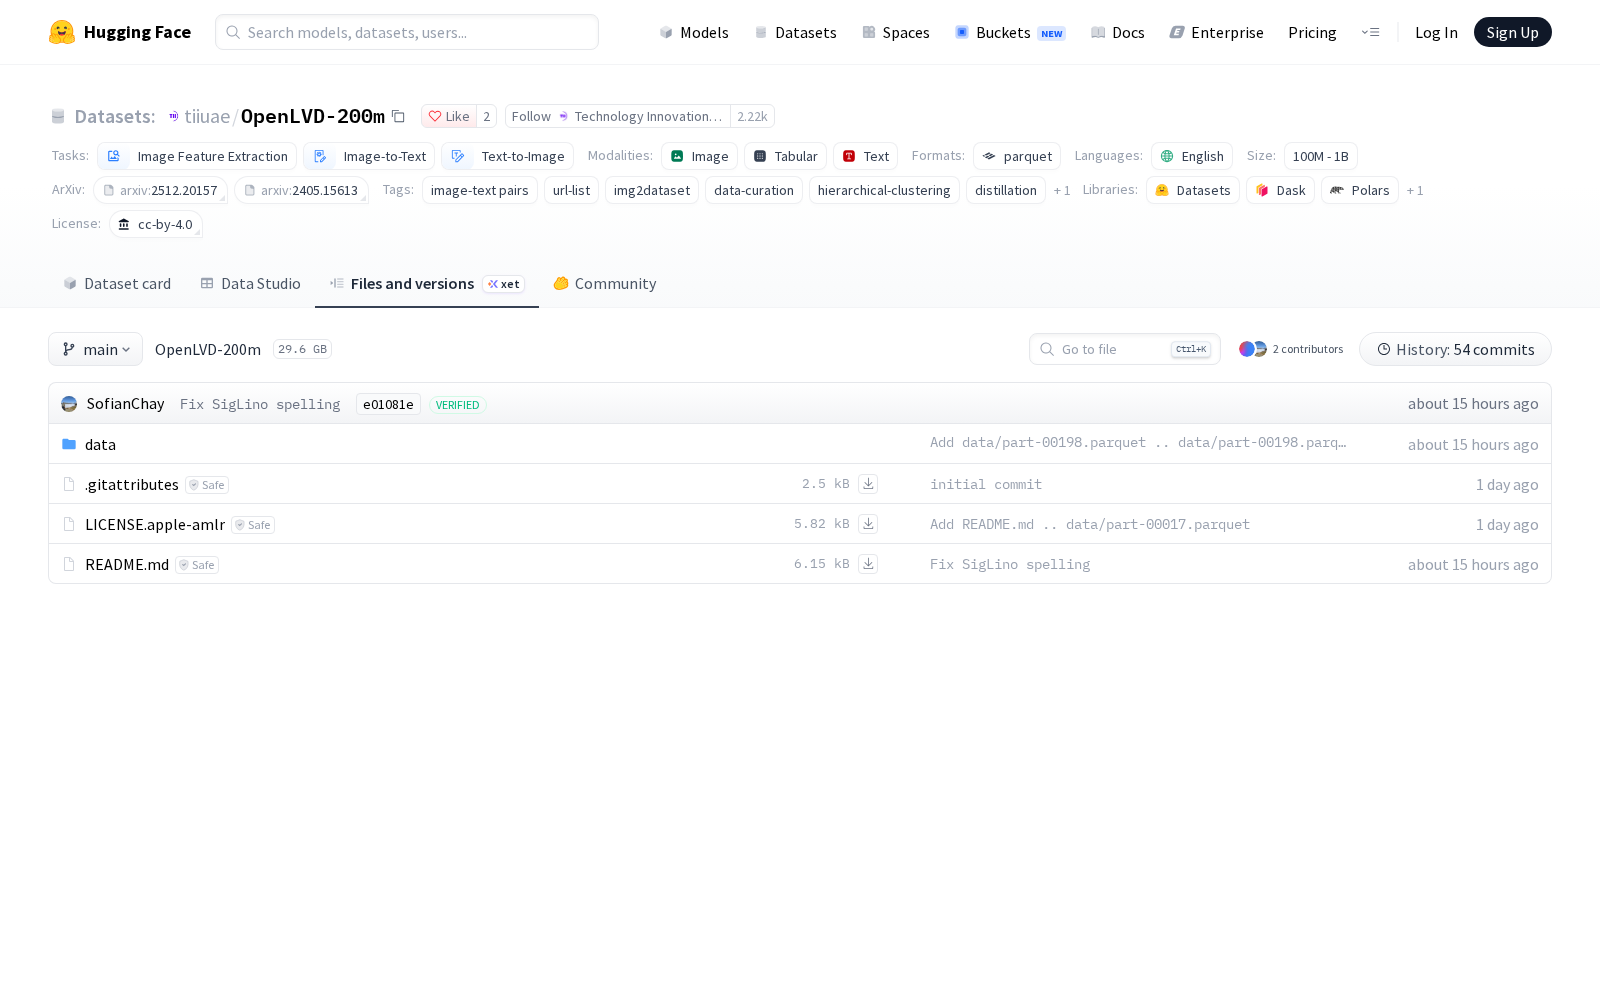
当前多模态大模型、视觉基础模型的技术迭代进入深水区,高质量、结构化的训练数据已经成为制约模型性能提升、研发效率优化的核心瓶颈。尤其是在大模型蒸馏、细分场景模型微调、图文数据策展等环节,业内普遍面临样本覆盖不全、数据结构零散、合规性不足等痛点。在此背景下,前沿技术研究机构Technology Innovation Institute(简称TII)正式推出全新数据集产品OpenLVD-200m,并于2026年10月22日首发上线AI开源社区HuggingFace。
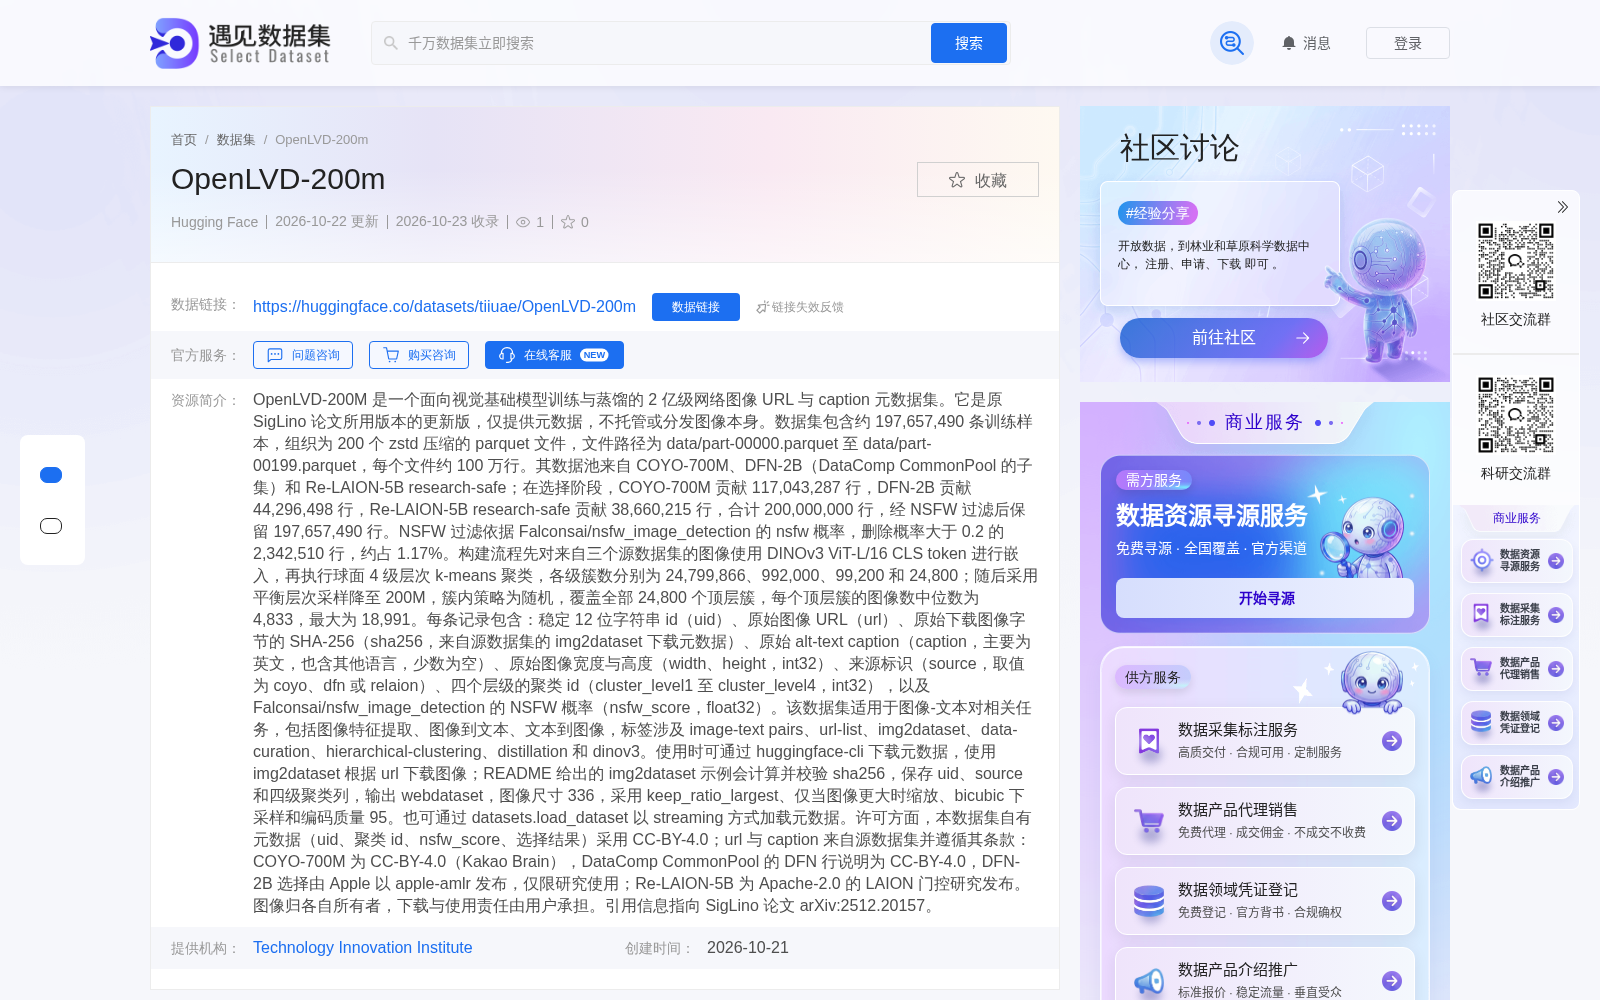
据公开信息显示,OpenLVD-200m是面向视觉基础模型训练与蒸馏的2亿级网络图像URL与caption元数据集,为原SigLino论文所用版本的迭代更新版,仅提供元数据,不托管或分发图像本身,从产品设计层面规避了大规模图像分发的版权风险。数据集最终包含约197,657,490条训练样本,组织为200个zstd压缩的parquet文件,单个文件容量约100万行,方便研究人员按需拆分使用。
该数据集的数据源覆盖当前业内主流的三大开源图文数据集:COYO-700M、DFN-2B(DataComp CommonPool的子集)和Re-LAION-5B research-safe,三大数据源分别贡献117,043,287行、44,296,498行、38,660,215行,原始样本总量达2亿条。为保障数据合规性,数据集构建阶段采用Falconsai/nsfw_image_detection模型进行内容过滤,删除NSFW概率大于0.2的2,342,510条样本,占原始样本量的1.17%。为提升样本多样性与结构化程度,研发团队先对所有样本的图像使用DINOv3 ViT-L/16 CLS token进行嵌入,再执行球面4级层次k-means聚类,各级簇数分别为24,799,866、992,000、99,200和24,800;随后采用平衡层次采样策略降至2亿样本规模,簇内采用随机采样方式,实现对全部24,800个顶层簇的全覆盖,每个顶层簇的图像数中位数为4,833,最大为18,991,充分保障了数据集的语义覆盖广度与样本分布均衡性。
每条样本包含10个核心字段,分别为稳定12位字符串id(uid,方便样本溯源与管理)、原始图像URL(url)、原始下载图像字节的SHA-256(sha256,用于图像校验)、原始alt-text caption(caption,以英文为主,覆盖多语言场景)、原始图像宽高参数(width、height)、来源标识(source,取值为coyo、dfn或relaion,方便使用者遵循对应数据源的许可要求)、四个层级的聚类id(cluster_level1至cluster_level4,支持分层筛选采样)、NSFW概率(nsfw_score,支持分级合规过滤),可满足不同研发场景的个性化数据需求。
从应用价值来看,OpenLVD-200m可覆盖多类多模态AI研发场景:在视觉基础模型蒸馏环节,分层聚类的结构支持研发人员针对性选取不同语义簇的样本,提升蒸馏效率与小模型的泛化能力;在图文对数据策展环节,完善的标签体系可大幅降低数据清洗、筛选的工作量,快速生成符合特定场景需求的数据集子集;除此之外,该数据集还可应用于图像特征提取模型训练、图生文/文生图模型微调、多模态对齐技术研究等方向,为各类AI研发工作提供数据支撑。
使用方面,研究人员可通过huggingface-cli下载元数据,使用img2dataset根据url下载图像,官方README提供了完整的img2dataset使用示例,支持自动校验sha256、输出webdataset格式;也可通过datasets.load_dataset以流式方式加载元数据,无需全量下载即可开展研发工作。许可层面,该数据集自有元数据(uid、聚类id、nsfw_score、选择结果)采用CC-BY-4.0协议,URL与caption遵循对应源数据集的许可条款,图像归各自所有者所有,下载与使用责任由用户自行承担,数据集的引用信息指向SigLino论文arXiv:2512.20157。
作为AI产业的核心生产要素,高质量训练数据集的开放共享是推动技术普惠创新的重要基础。本次OpenLVD-200m的发布,不仅填补了面向蒸馏、策展场景的结构化图文元数据的供给空白,也为开源数据集的规范化构建、合规化共享提供了可参考的实践范式,有望进一步降低视觉大模型的研发门槛,推动多模态AI技术在更多实体产业场景的落地应用。
Dataset card内容:
Files and versions内容: