全球AI数据机构LAION发布多语言语音演示数据集 开源许可赋能TTS与声音表演AI研发
作为全球知名的非营利AI数据研究机构,LAION eV曾因开源支持Stable Diffusion训练的LAION-5B图文数据集成为全球AIGC领域的核心基础设施供给方,在多模态数据集的合规开源建设领域拥有广泛行业影响力。近年来随着生成式AI语音赛道的快速发展,多语言、带场景表演属性的标准化测试演示数据集,一直是文本转语音(TTS)、AI配音、虚拟人语音等方向研发团队的核心刚需,高质量、合规可商用的语音类数据集也是当前数据要素市场中多模态资源的重要组成部分。
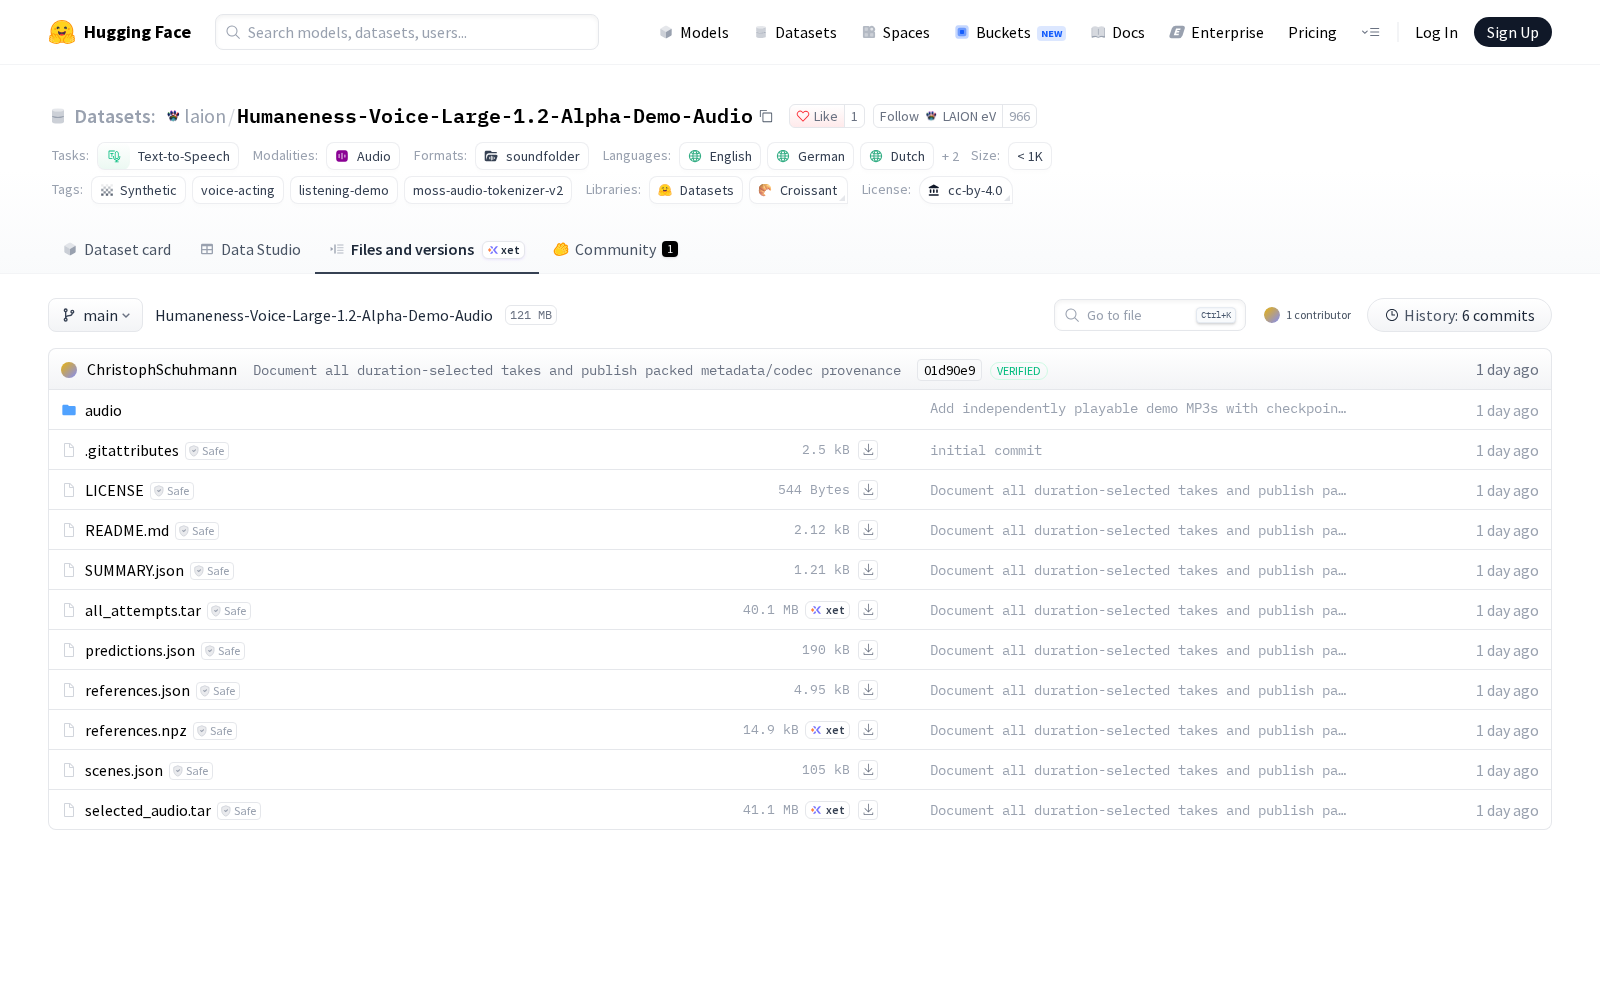
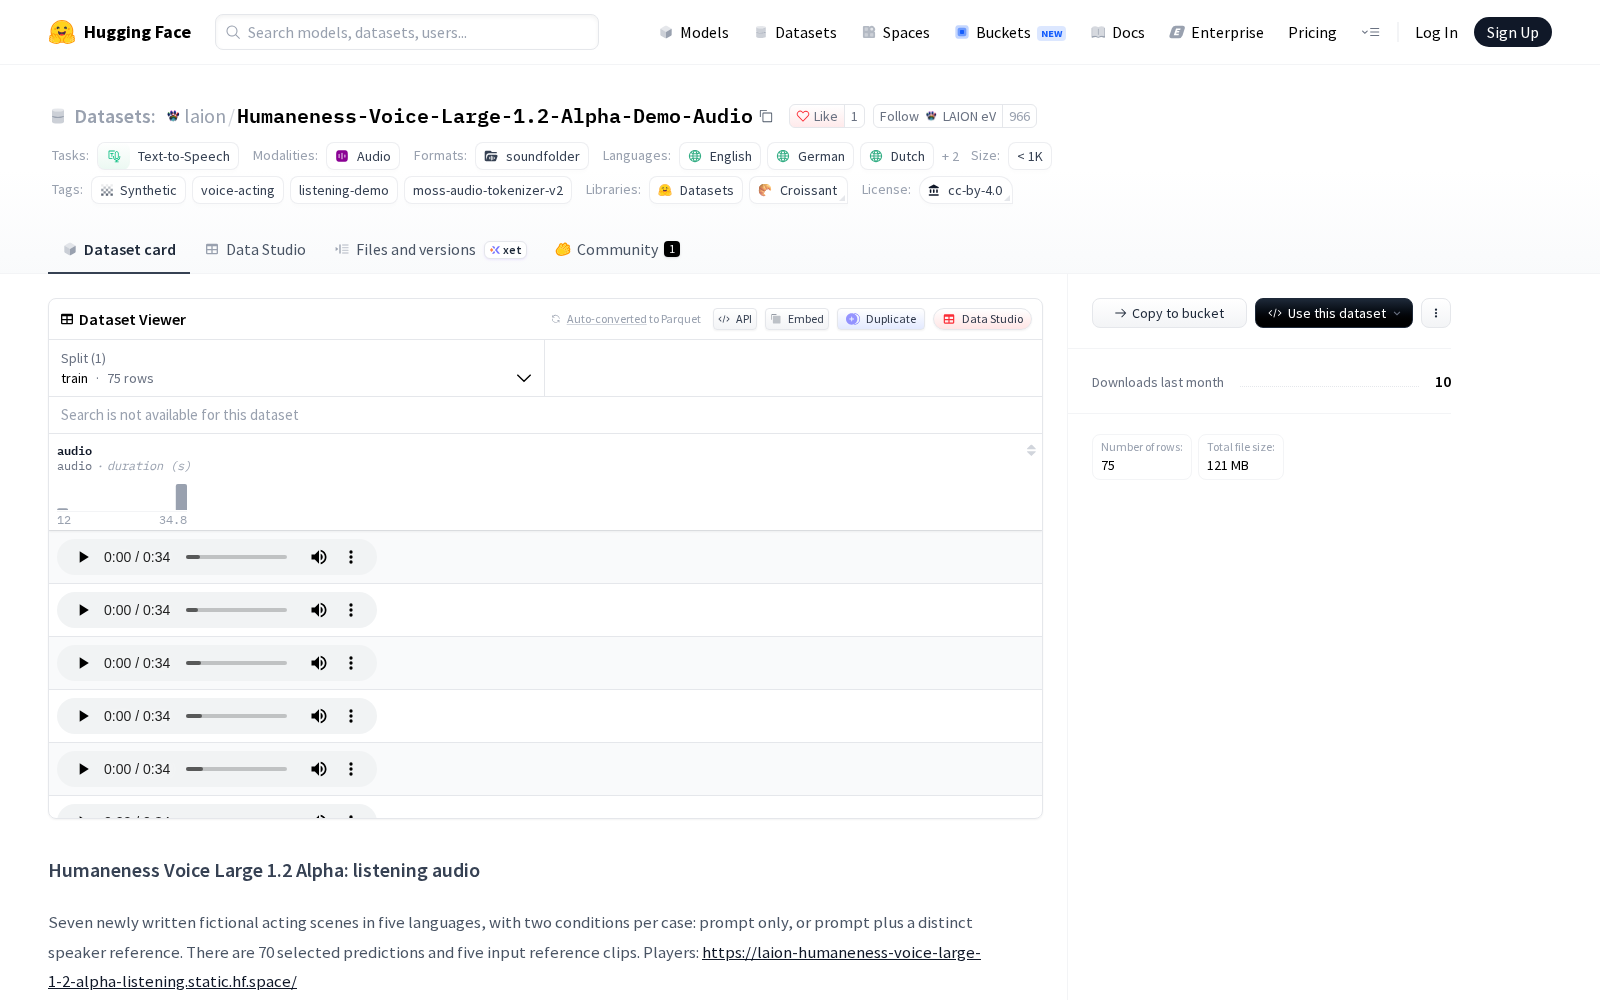
2026年10月22日,LAION eV正式在HuggingFace平台首发Humaneness-Voice-Large-1.2-Alpha-Demo-Audio数据集,该数据集定位为面向文本到语音合成与声音表演领域的实验性聆听演示资源,采用商用友好的CC BY 4.0许可,使用者仅需按要求署名即可合法使用,大幅降低了中小研发团队的资源获取门槛。
本次发布的数据集共包含7个全新撰写的虚构表演场景,覆盖英语、德语、荷兰语、法语、西班牙语五大主流语种,每个场景设置两种测试条件:仅提供生成prompt,或在prompt基础上附加不同说话人的参考音频,可满足不同技术路径的语音模型验证需求。数据集内共收录70条经过筛选的模型预测结果、5条公开来源的输入参考片段,单场景目标时长为34.8秒,所有样本的实际时长、随机种子、完整prompt及筛选诊断信息均完整记录在scenes.json与predictions.json文件中。
在筛选规则上,该数据集仅以时长作为唯一筛选标准:若首次生成结果不在30-40秒区间内,最多再尝试两个确定性种子,优先展示首个符合时长要求的结果,若无符合要求样本则展示时长最接近的结果,未引入MOS(平均主观得分)、WER(词错误率)或其他奖励机制筛选,所有生成尝试(包括未选中的结果)均完整保留在all_attempts.tar文件中,且没有任何片段经过裁剪或时间拉伸处理,最大程度保留了模型生成的原始状态,为算法优化提供了更全面的原始数据。
文件结构方面,数据集的audio/目录提供了适合浏览器流式播放的128kbps单声道MP3文件;selected_audio.tar压缩包包含选中音频、对应元数据及12码本MOSS-v2数组;all_attempts.tar则包含所有候选生成结果、对应的codec数组及JSON标注文件,编码格式为每80毫秒帧对应12个索引,即每秒150个索引。此外,数据集中的5条参考片段来自公开合成语料库laion/german-english-voice-acting-challenges的编解码重建裁剪片段,同样采用CC BY 4.0许可,源UID、说话人信息、时长及署名信息均完整记录在references.json文件中。LAION方面特别提示,参考片段为输入资源而非模型预测结果或原始无损录音,除参考片段外的所有脚本及预测结果均为本次发布的全新创作内容;使用者需遵循CC BY 4.0许可要求,署名LAION contributors、Humaneness Voice Large 1.2 Alpha及2026年份,参考片段需额外署名对应源语料,同时需遵守上游条款及人格权相关规定。
从行业应用价值来看,该数据集虽然定位为实验性聆听演示资源,不具备统计代表性的质量基准属性,也不可作为模仿工具使用,但仍然可为多个领域的研发工作提供支撑:多语言TTS研发团队可基于该数据集测试不同语种下的语音生成表现力、场景适配能力;AI配音、有声书生成、虚拟人语音等声音表演类AI产品团队可通过两种prompt条件的对比测试,优化参考音频引导的生成效果;学术研究机构可基于全量的生成尝试数据,开展语音生成时长控制算法、多语言语音生成跨语言迁移等方向的研究。本次开源发布也为全球AI语音领域的数据集建设提供了合规开源的参考样本,进一步丰富了多模态开源数据要素供给,推动多语言语音AI技术的普惠发展。
查看Humaneness-Voice-Large-1.2-Alpha-Demo-Audio
Dataset card内容:
Files and versions内容: