Meta AI发布MemProBench基准数据集 覆盖智能体记忆与第一人称视频情景记忆评测场景
随着大模型与具身智能技术的快速落地,智能体的长期记忆能力已经成为制约其从“单次任务执行”向“长期场景交互”升级的核心瓶颈:无论是消费端的陪伴型智能助手,还是工业端的巡检、服务机器人,都需要稳定的上下文记忆、情景回溯能力才能适配真实使用需求,但长期以来,业内缺乏针对智能体记忆能力的标准化评测基准,不同团队的测试结果难以横向对比,一定程度上拖慢了技术迭代效率。
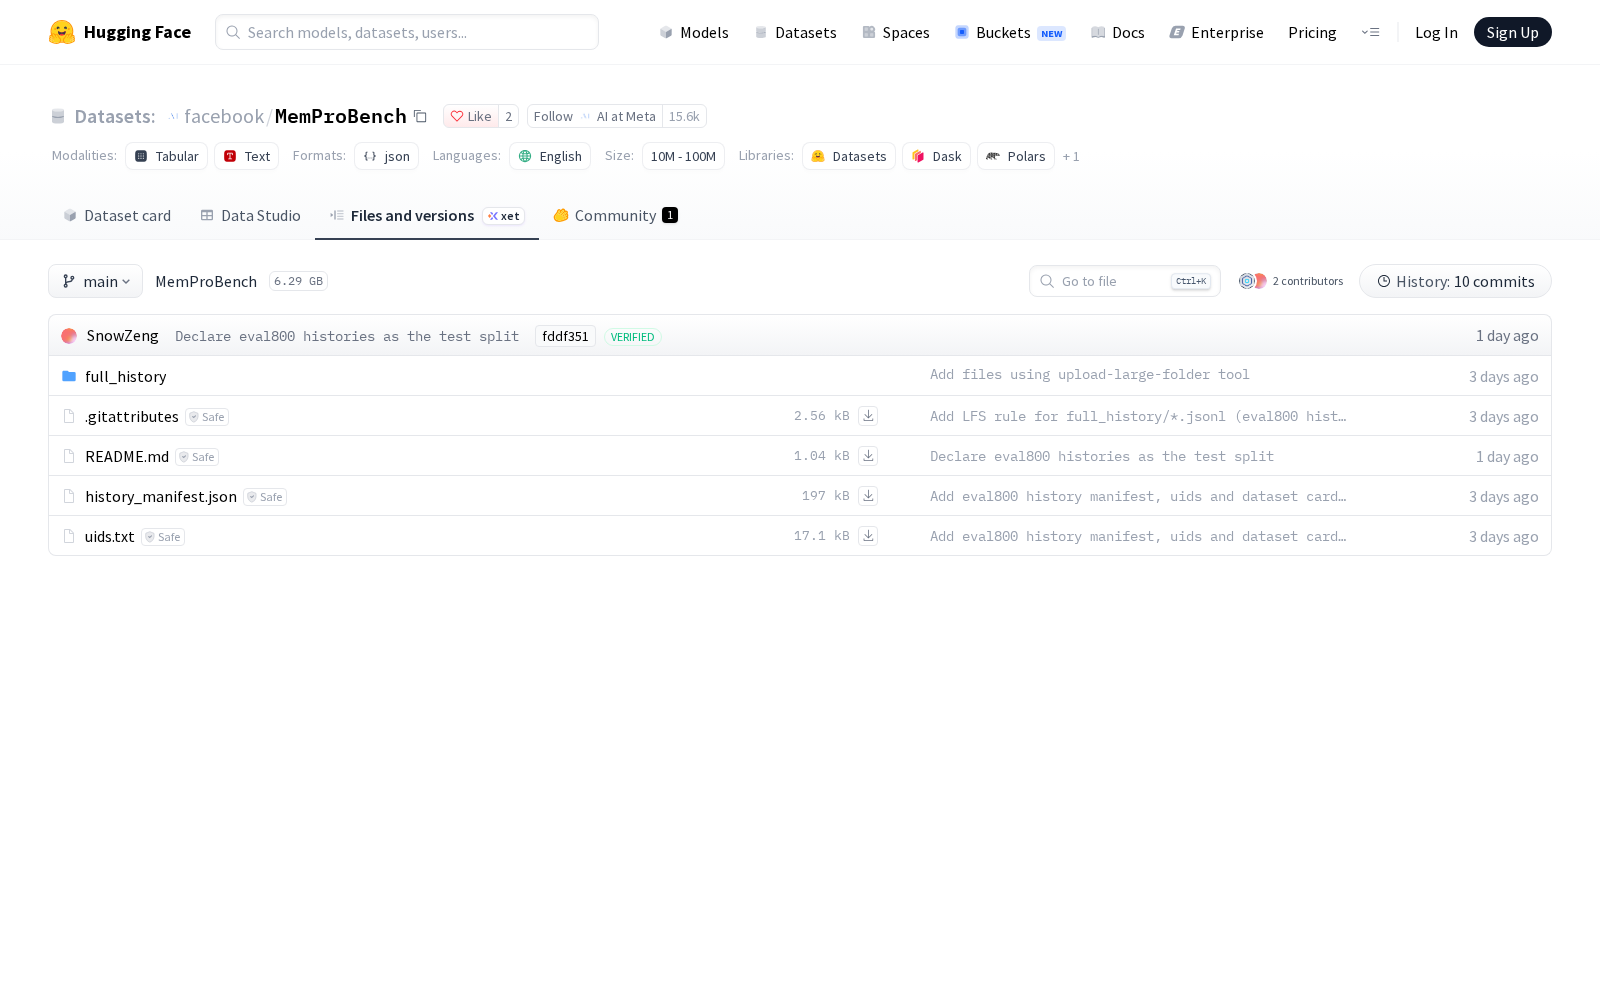
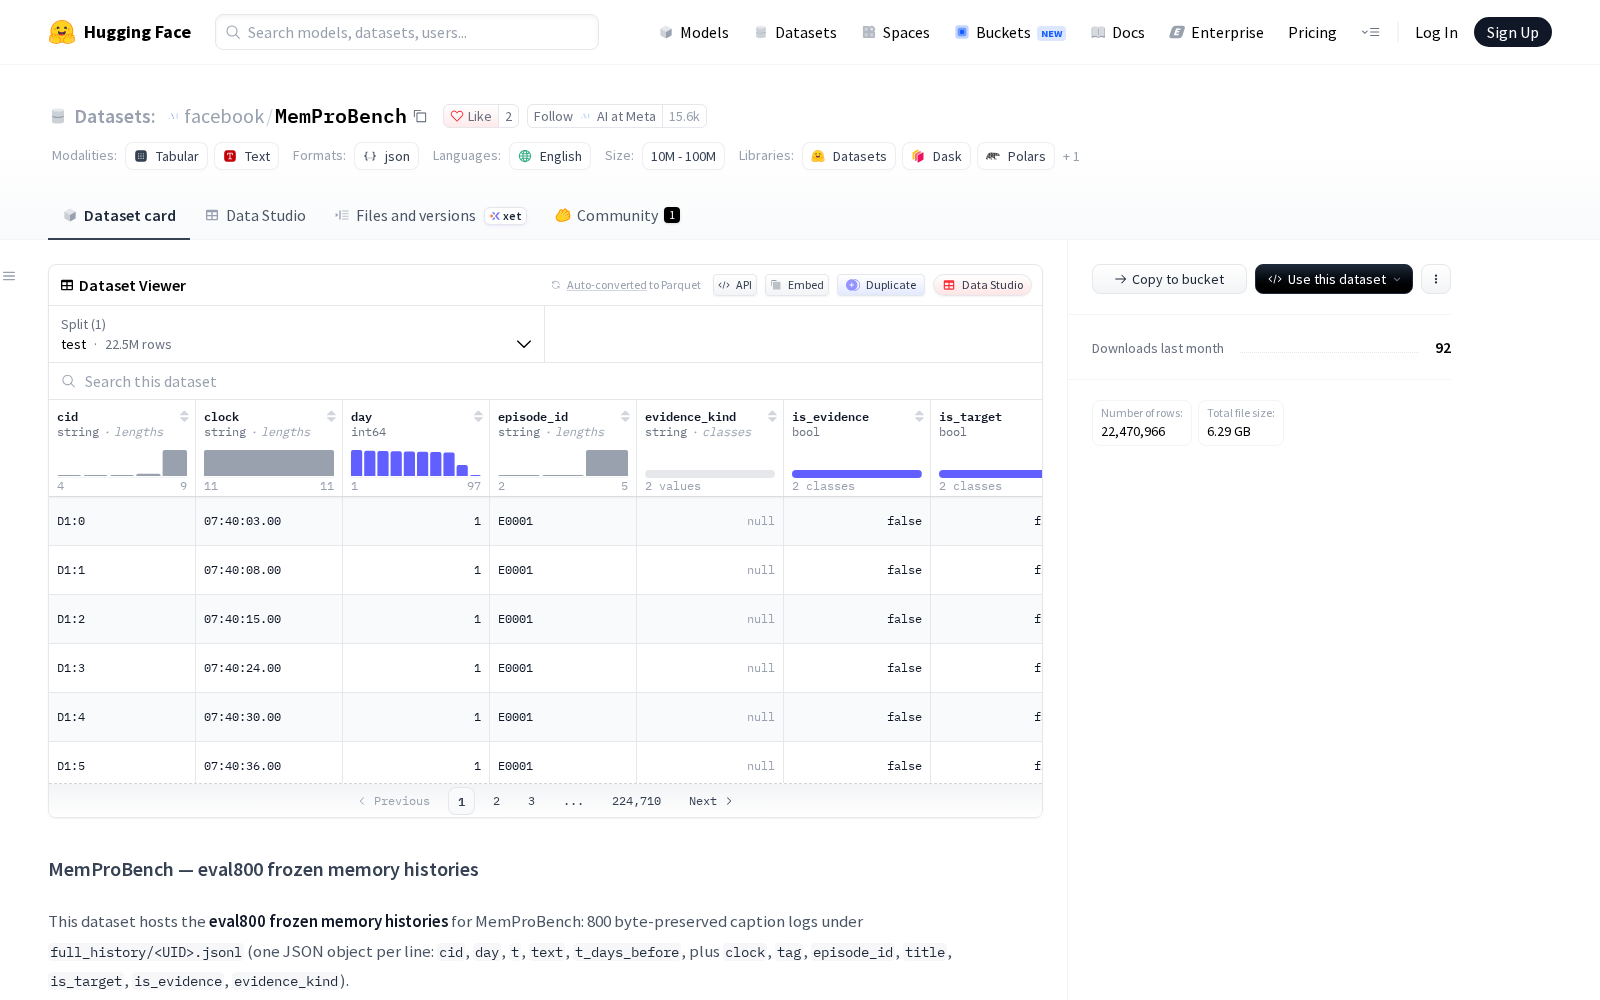
2026年10月22日,Meta旗下AI研究部门AI at Meta在HuggingFace平台正式首发MemProBench英语数据集,瞄准智能体记忆评测、第一人称视频情景记忆两大核心研发方向,为行业提供了统一的测试基底。据公开信息显示,MemProBench托管有eval800冻结记忆历史,共包含800条规范排序的评估历史,顺序由uids.txt统一定义。数据集以字节保留的caption日志形式存储,每条评估历史对应full_history/目录下的独立JSONL文件,文件为原始caption字节流,每行对应一个包含完整字段的JSON对象,覆盖cid、day、t、text、t_days_before基础字段,同时额外搭载clock、tag、episode_id、title、is_target、is_evidence、evidence_kind等扩展维度,可支撑多维度的评测规则定制。此外,history_manifest.json文件提供了所有数据文件的字节数、记录数、sha256校验值等清单信息,可保障数据集下载与使用的完整性。
值得注意的是,该数据集的源视频来自官方Ego4D片段,并未随数据集同步分发,用户下载该私有数据集需要提前获得HuggingFace的读取权限,官方README文档同步提供了配套代码项目链接、HuggingFace下载命令,明确说明该数据集可用于读取、检查MemProBench的冻结记忆历史,可与Memo-Pro-Agent代码配套使用。
从应用价值来看,MemProBench的落地有望为多个AI研发场景提供支撑:在智能体记忆评测方向,研发团队可依托其标准化的冻结记忆历史,测试不同架构大模型驱动的智能体在多轮交互后的信息召回准确率、上下文关联能力、长期记忆遗忘率等核心指标,解决此前不同团队评测标准不统一、测试结果不可比的痛点;在第一人称视频情景记忆方向,该数据集可支撑具身智能机器人的环境记忆回溯能力测试、可穿戴智能设备的用户生活场景语义提取能力验证、安防领域第一视角执法记录仪的内容快速检索算法优化等多个方向的研发工作。作为AI基础设施的核心组成部分,高质量的基准数据集是人工智能技术迭代的核心底座,此次Meta发布的MemProBench,进一步丰富了全球AI评测数据集的品类,为推动通用人工智能向“具备长期交互能力、场景感知能力”的方向迭代提供了重要支撑,也为数据要素市场中AI训练评测类数据的规范化供给提供了参考样本。
Dataset card内容:
Files and versions内容: